H3 长视频提示词规划 (H3-Long-Video-Prompting)
H3 长视频提示词规划
把超过 15 秒的镜头想法,变成一段一段能跑出来的分镜方案。
MiniMax H3 一次只能生成 15 秒。想做一个 40 秒的短片,你面对的不是"写一条更好的提示词",而是拆段、定模式、锁一致性、处理接缝这一整套工程问题。这个技能就是把这件事做完,直接给你可提交的东西。
它解决的是一个硬限制
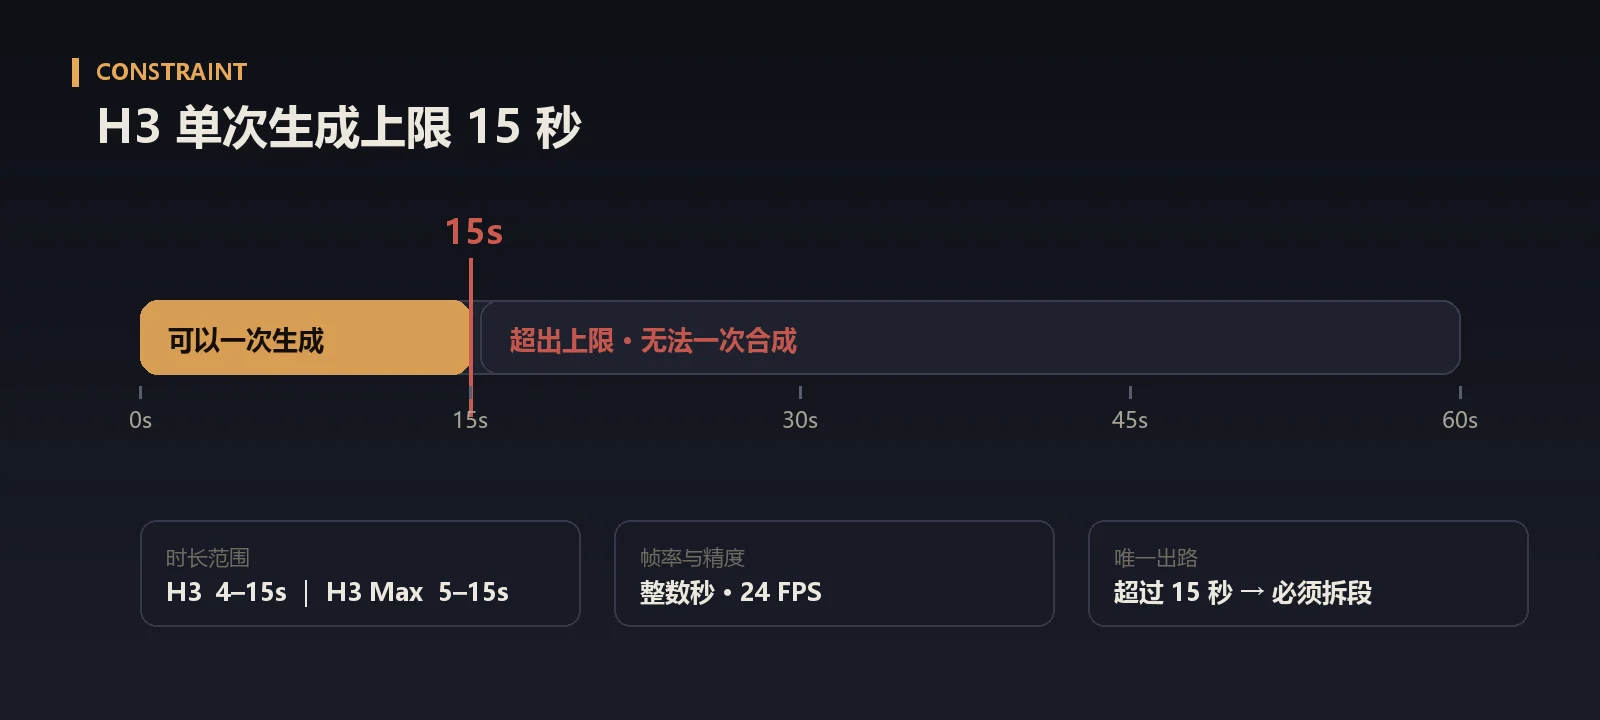
| 项目 | 规格 |
|---|---|
| H3 | 4–15 秒 |
| H3 Max | 5–15 秒 |
| 秒数 | 必须是整数 |
| 帧率 | 24 FPS |
超过 15 秒没有任何技巧可以绕过,只能拆。拆得好不好,决定成片能不能看——大部分人卡住的地方不是"不会拆",而是拆完之后每一段的脸不一样、色温不一样、镜头对不上。
三步:拆段 → 定模式 → 锁锚点
1 · 拆段
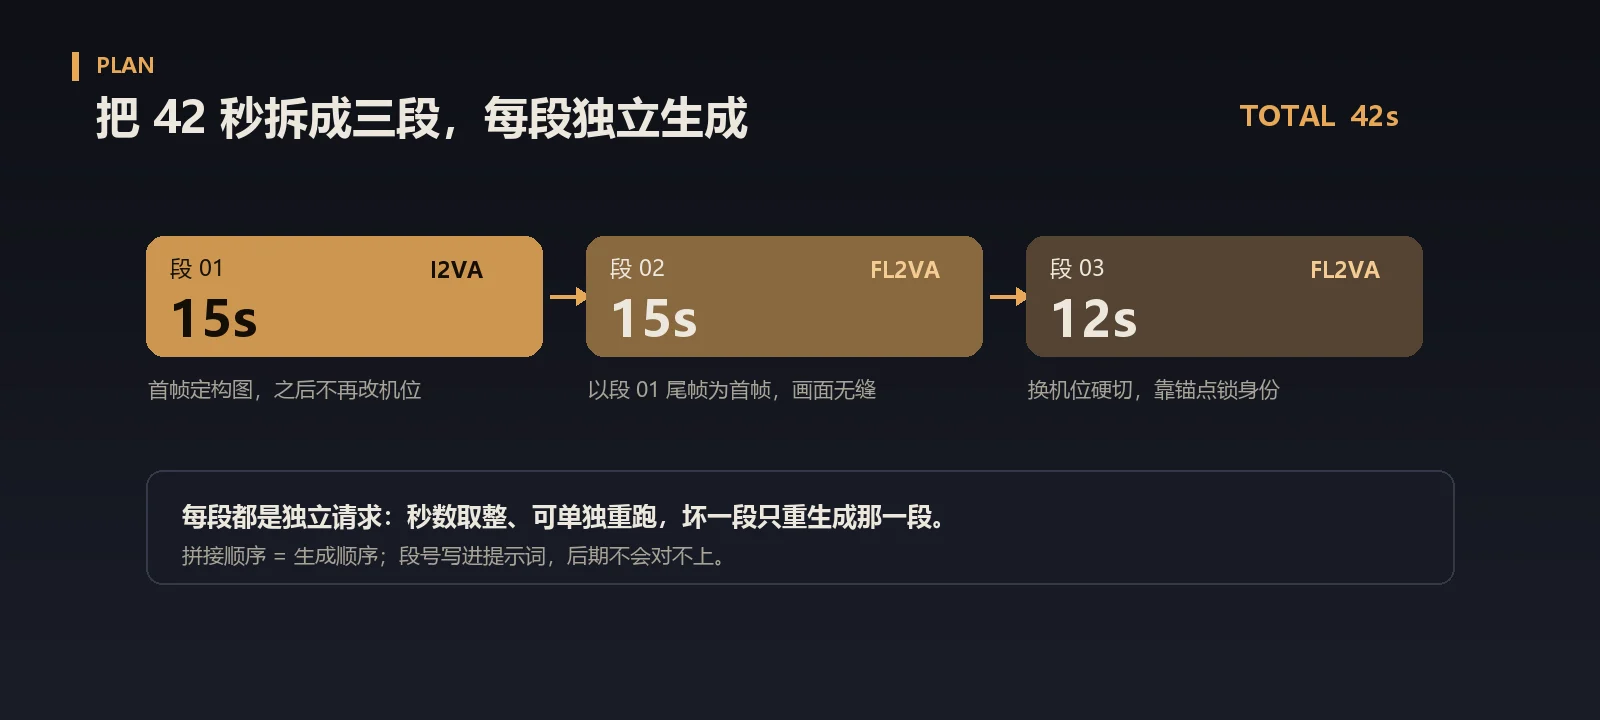
- 每段 ≤ 15 秒整数秒,按动作节点切,不按时间对半砍
- 每段是一个独立请求:单独可重跑,坏一段只重生成那一段
- 段号写进提示词,后期拼接不会错位
2 · 定模式
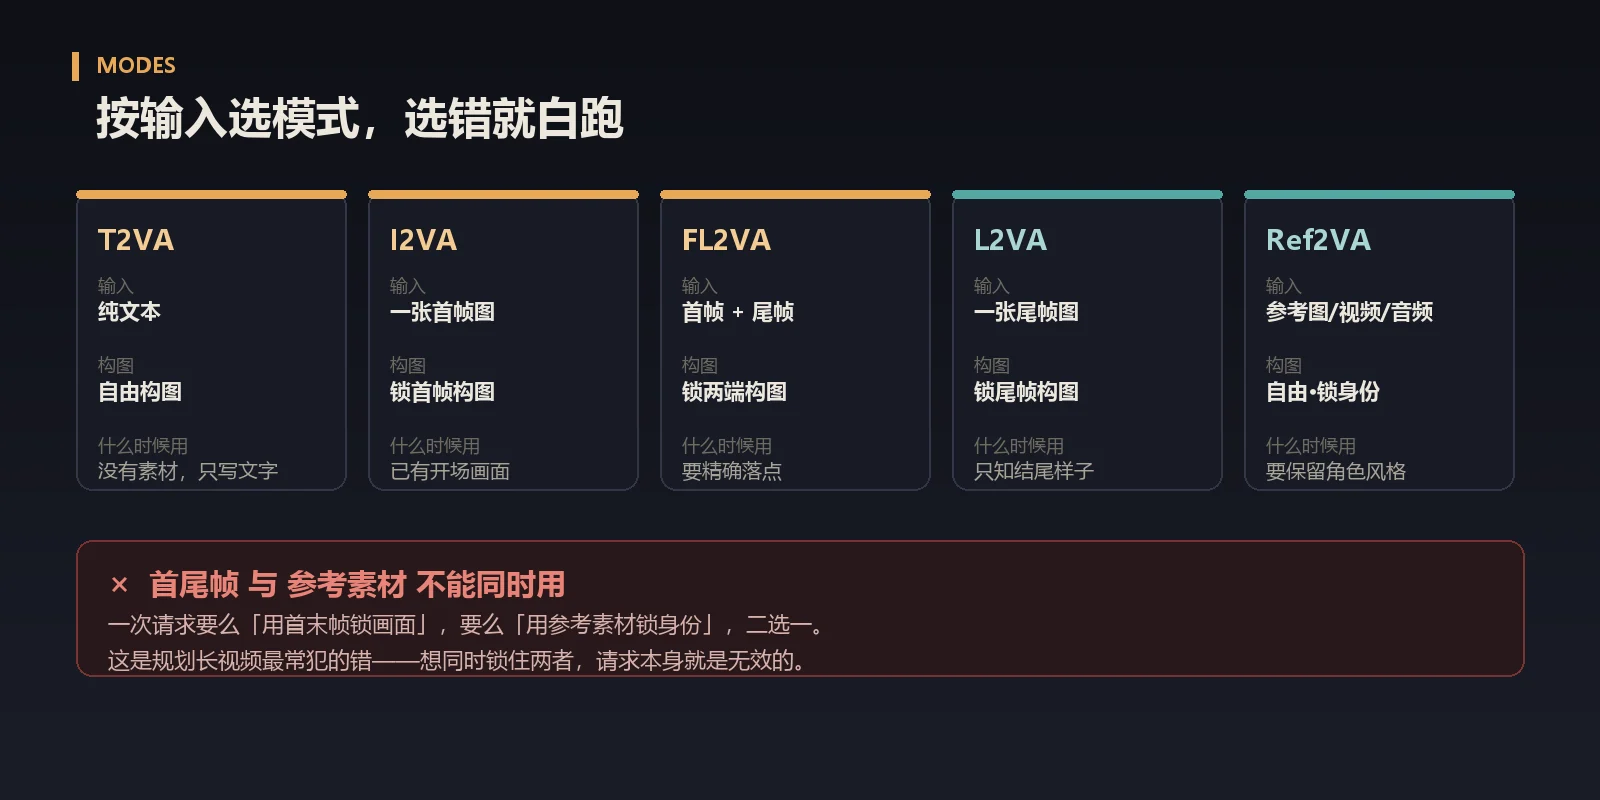
| 模式 | 输入 | 构图 | 什么时候用 |
|---|---|---|---|
| T2VA | 纯文本 | 自由 | 没有素材,只写文字 |
| I2VA | 一张首帧图 | 锁首帧 | 已有开场画面,要它动起来 |
| FL2VA | 首帧 + 尾帧 | 锁两端 | 要精确落点,比如指定收尾姿势 |
| L2VA | 一张尾帧图 | 锁尾帧 | 只知道结尾长什么样 |
| Ref2VA | 参考图 / 视频 / 音频 | 自由但锁身份 | 要保留角色、风格、音色 |
⚠️ 最容易犯的错:首尾帧和参考素材不能同时用。一次请求里要么「用首末帧锁画面」,要么「用参考素材锁身份」,二选一。想两个都锁,请求本身就是无效的。
3 · 锁锚点,再逐段写
一致性的关键不是"每段都描写一遍脸",而是一套锚点句全段复用:
- 脸型、五官、发型、服装、配饰写成固定句,一段不改
- 色温、光位、镜头焦段固定,不随段落漂
- 画幅、帧率、禁用项(字幕 / 水印 / 多余人物)固定在全局设置里
模型生成每一段时都是"第一次见这个角色",所以锚点必须每段都带。
接缝:尾帧接续 还是 跳切
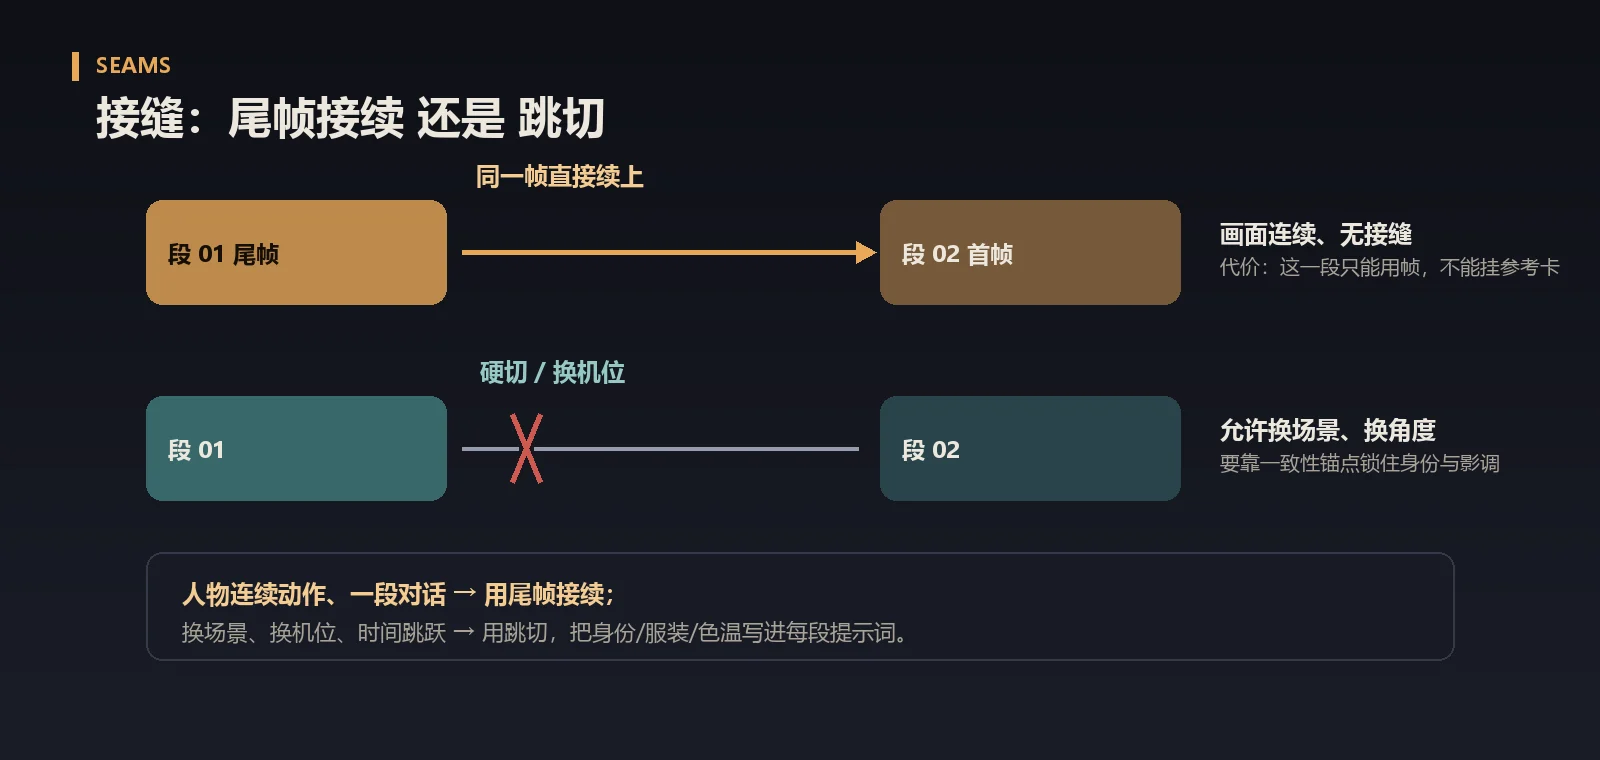
| 情况 | 用哪种 | 代价 |
|---|---|---|
| 人物连续动作、一段对话 | 尾帧接续(段 1 尾帧当段 2 首帧) | 这一段只能用帧,不能再挂参考卡 |
| 换场景、换机位、时间跳跃 | 跳切 | 靠一致性锚点锁身份与影调 |
选错就会出现两种典型事故:该连续的地方闪了一下(用了跳切),该换机位的地方却死板不动(硬接尾帧)。
你会拿到什么
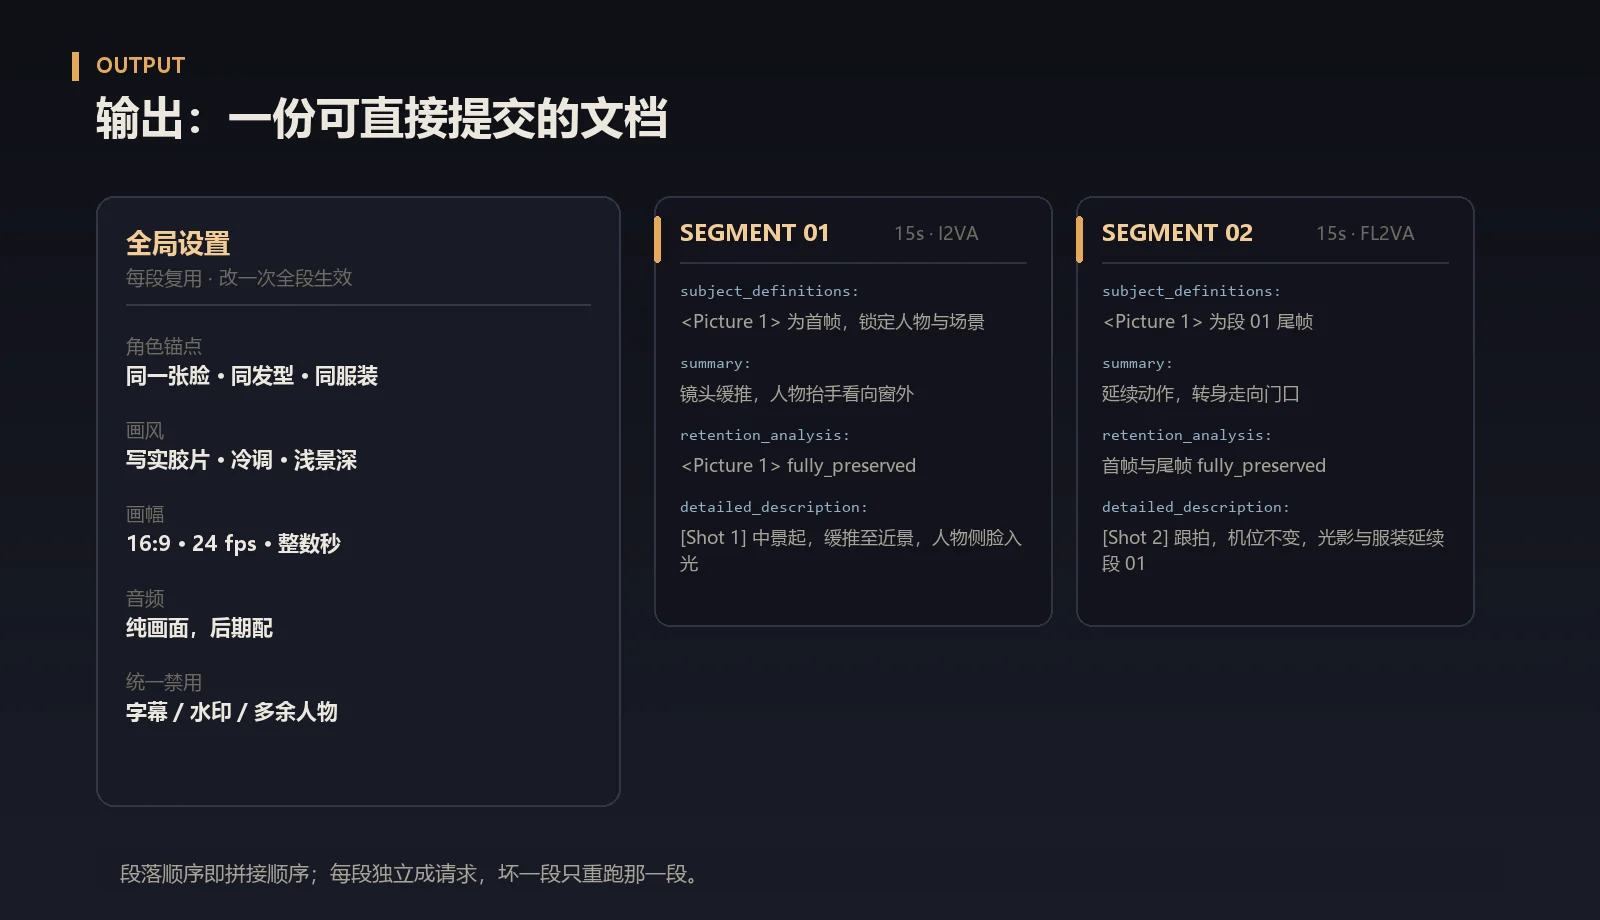
一份 Markdown 文档,两部分:
- 全局设置——角色锚点、画风、画幅、音频、统一禁用项,一次写清,全段复用
- 每段一条完整 prompt——按 H3 的六段结构写全,复制即可提交:
subject_definitions:
<Picture 1> is the first frame; it locks the character, wardrobe and location.
summary:
[Shot 1] A slow push-in as she raises a hand toward the window.
retention_analysis:
<Picture 1> fully_preserved — face, hair and wardrobe unchanged.
detailed_description:
[Shot 1] Medium shot opening, pushing to close-up over 6 seconds...
overall_soundscape:
Quiet room tone, fabric movement.
non_diegetic_music:
N/A
一个 42 秒的例子
| 段 | 时长 | 模式 | 锚点 | 内容 |
|---|---|---|---|---|
| 01 | 15s | I2VA | 首帧定构图 | 开场,人物入画 |
| 02 | 15s | FL2VA | 段 01 尾帧接续 | 连续动作,机位不变 |
| 03 | 12s | FL2VA | 换机位硬切 | 收尾,靠锚点锁身份 |
三段各自独立生成,拼起来是一条连续的 42 秒。
什么时候别用它
- 单段 ≤ 15 秒:不需要拆段,直接用
h3-prompt-writing写一条就行,多这一步反而是浪费 - 只是想写一条提示词、不涉及拼段:同上
- 需要精确对口型:那是数字人模式的活,不是分段规划要解决的问题
硬约束速查
| 约束 | 值 |
|---|---|
| 单段时长 | H3 4–15s / H3 Max 5–15s,整数 |
| 帧率 | 24 FPS |
| 首尾帧 vs 参考素材 | 互斥,同一请求不能同时用 |
| 画幅锁定 | I2VA / FL2VA / L2VA 跟随输入图,不能另指定 |
| 段间一致性 | 靠全局锚点句,不靠运气 |
常见问题
Q:能直接写一段 30 秒的提示词吗?
不能,模型上限 15 秒。写 30 秒只会得到一条 15 秒的片子或直接失败。
Q:为什么不能既给尾帧又给参考图?
平台把这两类输入定义为互斥分支。真需要"身份一致 + 画面接续",做法是拆段:连续段用尾帧接续,换机位段用参考素材。
Q:每段都要重新写一遍提示词吗?
不用。改主体句(这一段发生什么),锚点句原样搬过去。
Q:能并行生成吗?
参考素材的段可以并行;尾帧接续的段必须串行,因为下一段的首帧来自上一段的产物。
Q:音频怎么处理?
分段生成的音轨在接缝处必然有断层。要么整段无声、后期统一配音,要么在重音/换气处切,别在词中间切。
v2.0 · 基于 MiniMax H3 官方文档、fal.ai / Atlas Cloud / EmpirioLabs 的 H3 API schema 与 Scenario H3 handbook 整理。