
사이트 검색노출 점검표 | 구글·네이버 기술 검사
주소 하나로 검색 노출 기술 항목을 점검합니다
사이트를 운영하다 보면 title 몇 개가 비었는지, 사이트맵에서 빠진 쪽이 어디인지, 네이버 Yeti와 AI 크롤러가 robots.txt에서 허용되는지 한곳에서 보기 어렵습니다. 사이트 검색노출 점검표는 공개 사이트를 직접 읽고 발견한 항목을 파일로 남깁니다. 검색 순위나 트래픽을 예측하는 상품은 아닙니다.
점검 방식
웹사이트 주소
  → robots.txt 확인
  → 같은 도메인만 초당 1요청으로 크롤링
  → 쪽별 기술 항목과 내부 링크 검사
  → 사이트맵·크롤러 허용 규칙 비교
  → 한국어 PDF·CSV·JSON 생성
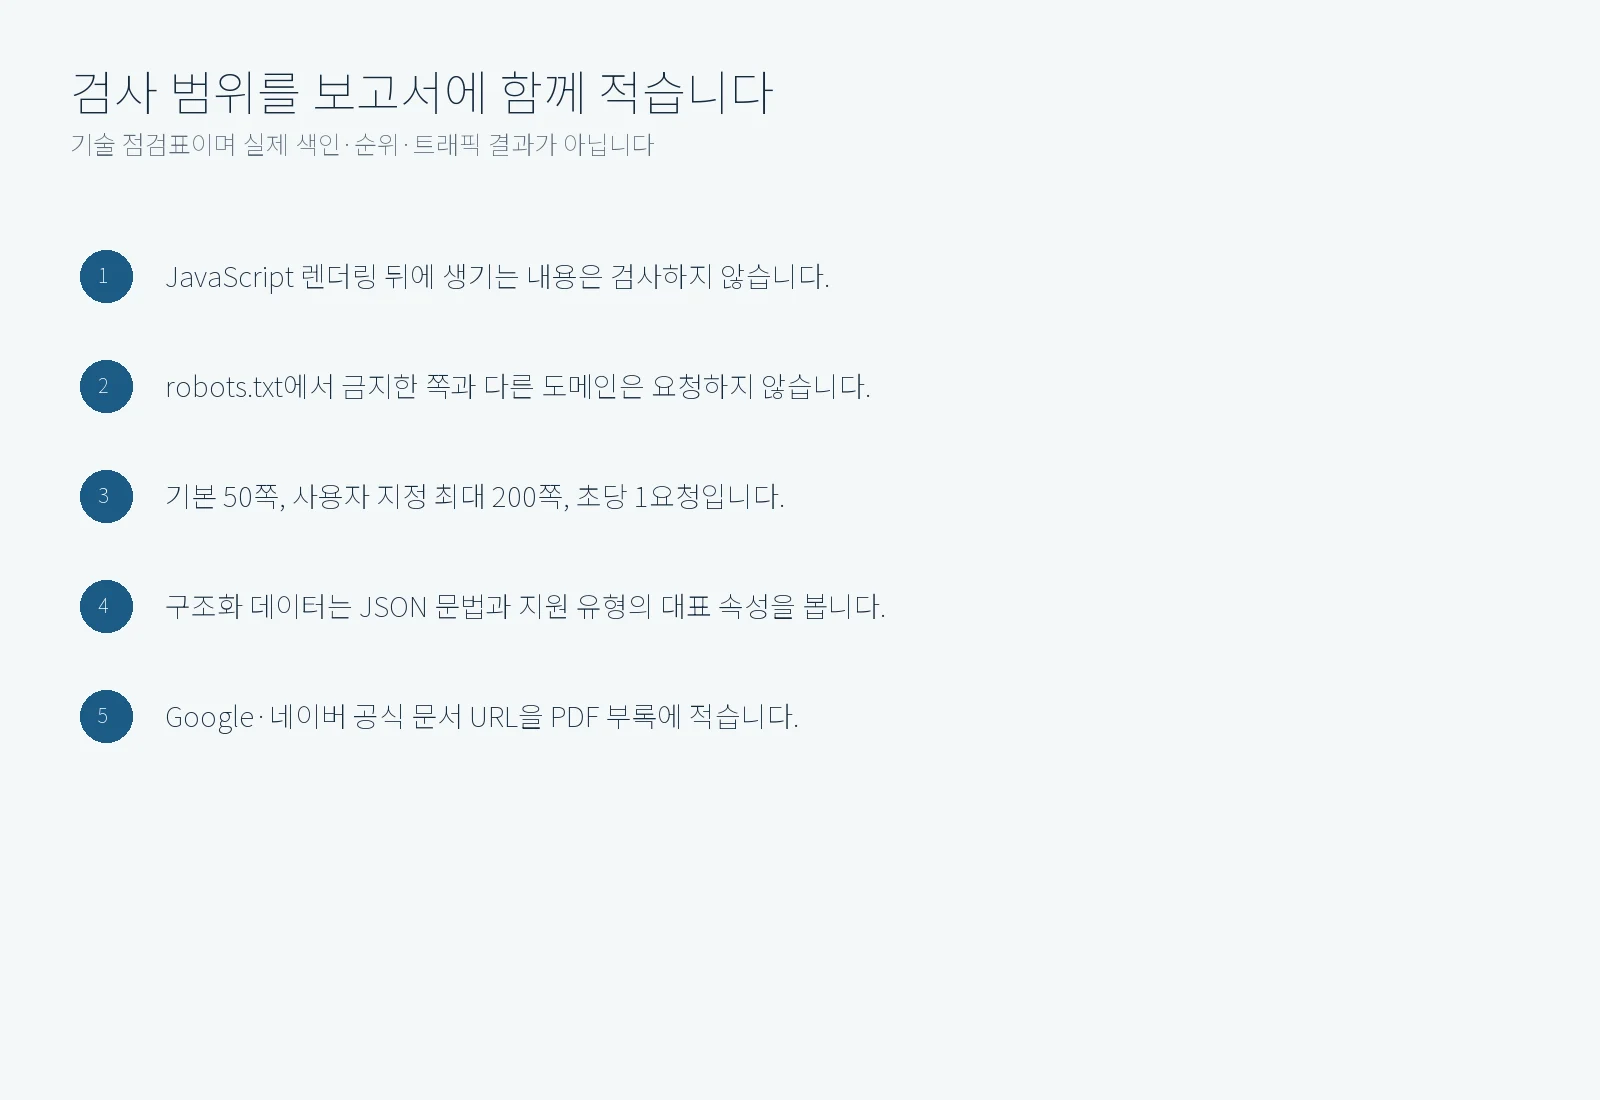
기본은 최대 50쪽입니다. 요청하면 최대 200쪽까지 올릴 수 있습니다. robots.txt에서 금지한 쪽은 열지 않으며 다른 도메인으로 넘어가지 않습니다.
확인하는 항목
| 구분 | 내용 |
|---|---|
| 접속 | HTTP 상태, 리다이렉트 체인, HTTPS, 혼합 콘텐츠, 응답 시간, HTML 크기 |
| 페이지 | title·meta description 유무·글자 수·중복, h1 개수, canonical, noindex, hreflang, viewport |
| 미디어·링크 | 이미지 alt 누락, 깨진 내부 링크, Open Graph, Twitter Card |
| 크롤링 | robots.txt 문법, sitemap.xml 유무·XML, 사이트맵에 없는 크롤링 쪽 |
| 구조화 데이터 | JSON-LD 문법, Article·Product 등 지원 유형의 대표 필수 속성 |
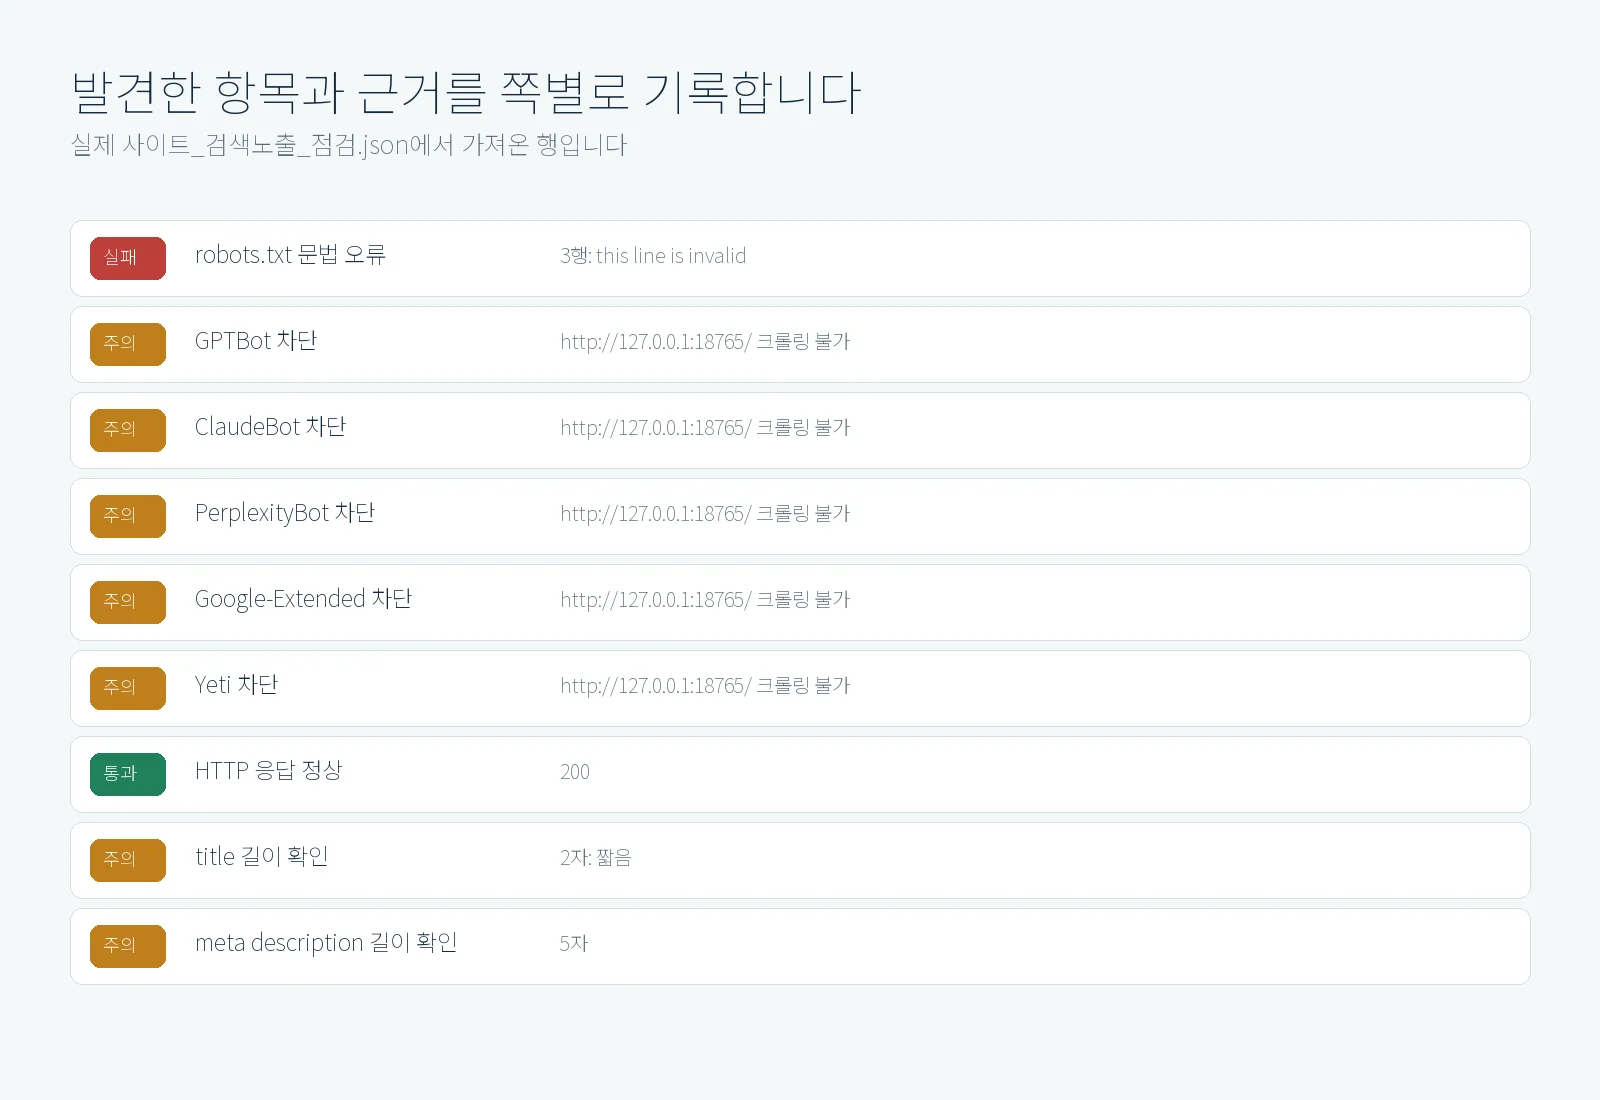
| 봇 | GPTBot, ClaudeBot, PerplexityBot, Google-Extended, 네이버 Yeti 허용 여부, llms.txt |
받는 파일
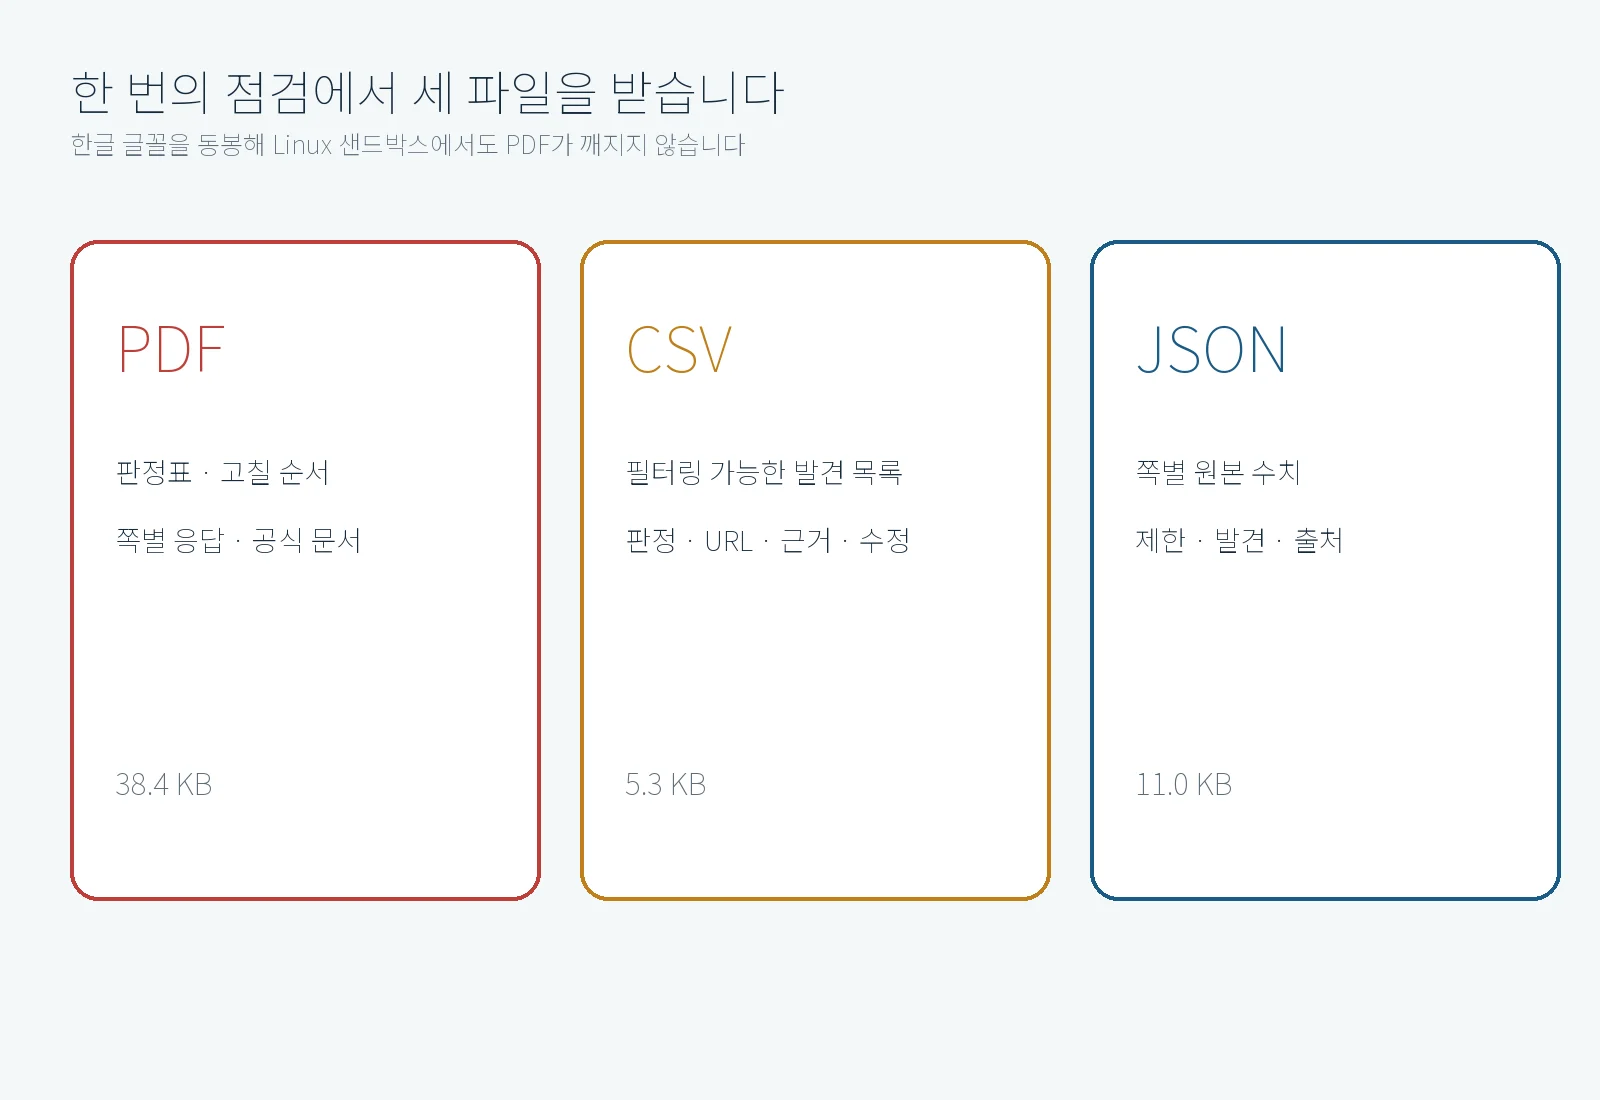
사이트_검색노출_점검표.pdf: 통과·주의·실패 표, 고칠 순서, 쪽별 응답 표, 공식 문서 부록사이트_검색노출_점검.csv: 발견 항목을 필터링할 수 있는 표사이트_검색노출_점검.json: 쪽별 수치와 발견 근거가 담긴 원본 데이터
발견된 항목만 근거로 고칠 순서를 설명하고, 필요한 경우 title·meta·canonical 같은 수정 태그 예시를 적습니다.
판정 수치를 확인했습니다
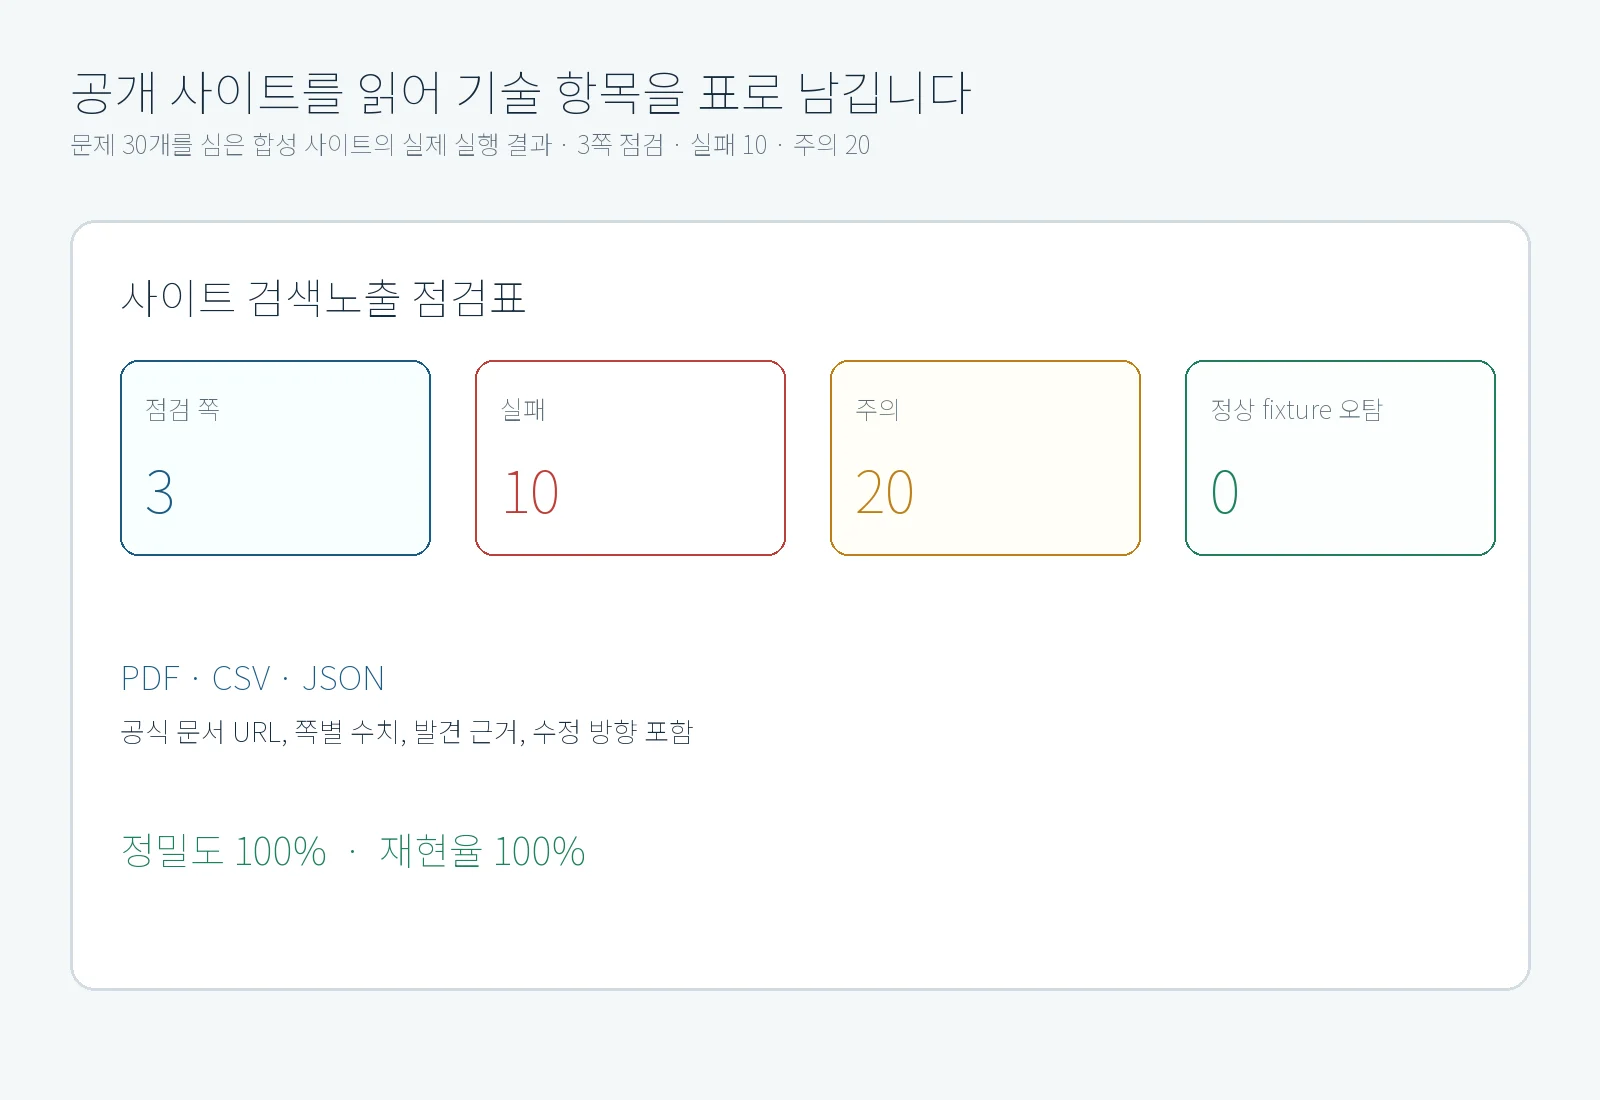
문제 30개를 심은 로컬 사이트에서 30개를 모두 찾았고 정밀도와 재현율은 각각 100%였습니다. 정상 fixture에서는 주의·실패 오탐이 0개였습니다. 이 수치는 동봉된 정답 fixture와 현재 검사 항목에 대한 결과이며 모든 웹사이트의 완전한 오류 탐지를 뜻하지 않습니다.
알아둘 한계
- JavaScript를 실행하지 않습니다. 렌더링 뒤에만 생기는 링크·태그·본문은 검사하지 못합니다.
- 로그인 뒤 페이지, 폼 제출, Google Search Console·네이버 서치어드바이저 계정 데이터는 보지 않습니다.
- 실제 색인 여부, 검색 순위, 노출량, 트래픽은 측정하거나 보장하지 않습니다.
- 구조화 데이터 검사는 JSON 문법과 지원 유형의 대표 필수 속성까지이며 리치 결과 자격을 보장하지 않습니다.
- title과 description 길이는 한글을 포함한 글자 수 기준의 점검 범위입니다. 실제 검색 화면의 잘림은 기기와 검색어에 따라 달라집니다.
이렇게 쓰세요
- 새 사이트 공개 전에 빠진 메타 태그와 깨진 내부 링크를 확인합니다.
- 리뉴얼 뒤 canonical, noindex, sitemap.xml과 robots.txt 설정을 다시 봅니다.
- 구글·네이버·AI 크롤러별 robots.txt 허용 상태를 한 표에서 비교합니다.
필요한 준비물
로그인 없이 열리는 공개 웹사이트 주소가 필요합니다. 사이트 소유자이거나 점검 권한이 있어야 합니다. 사설망과 localhost 주소는 받지 않습니다.
추천드립니다
- 한국어 보고서로 개발자와 수정 항목을 나눌 분
- 구글과 네이버의 기본 기술 요소를 함께 확인할 분
- PDF 요약과 CSV·JSON 원본이 모두 필요한 분
추천드리지 않습니다
- 실제 검색 순위나 유입 예측이 필요한 분
- JavaScript로만 구성된 화면을 브라우저처럼 검사해야 하는 분
- 로그인 계정, Search Console 또는 서치어드바이저 데이터를 분석하려는 분
자주 묻는 질문
사이트 전체를 검사하나요?
시작 주소에서 같은 도메인 링크를 따라 기본 50쪽, 사용자 지정 최대 200쪽을 검사합니다. robots.txt로 막힌 쪽은 제외합니다.
사이트에 부담을 주지 않나요?
초당 1요청으로 제한합니다. 페이지와 링크 확인도 같은 제한을 따릅니다.
네이버 기준도 들어가나요?
네이버 Yeti 허용 여부, 기본 메타·robots.txt·사이트맵 항목을 확인하고 네이버 서치어드바이저 공식 문서 URL을 부록에 적습니다.
점수가 높으면 순위가 오르나요?
그렇게 판단할 수 없습니다. 이 상품은 기술 상태를 정리하며 순위와 트래픽을 약속하지 않습니다.
수정도 해주나요?
사이트 파일을 직접 배포하지는 않습니다. 발견 근거와 고칠 순서, 필요한 태그 예시를 제공합니다.
이용 요금
| 플랜 | 가격 | 요청 한도 | 체험 |
|---|---|---|---|
| 일간 | $2.99 | 하루 5회 | 없음 |
| 주간 | $7.99 | 주 10회 | 1일, 무료 2회 |
| 월간 | $19.99 | 월 30회 | 없음 |
카테고리: 마케팅 (Marketing), 분석 (Analysis), 리서치 (Research)
예시 화면은 동봉된 합성 테스트 사이트의 실제 실행 결과입니다.
API externas
사용자가 입력한 웹사이트 도메인 · PyPI (pypi.org, files.pythonhosted.org)


