QuietCut : coupes de silences, listes
Illustration symbolique, et non une capture d’un résultat réel.
Raccourcissez les pauses d'un enregistrement et obtenez des listes de coupes exactes, un audio en fondu et un rapport.
Ce que fait QuietCut
QuietCut s'adresse aux podcasteurs, intervieweurs, enseignants et monteurs vidéo qui veulent resserrer les pauses d'un enregistrement avant le montage final. Il repose sur une détection de silence fondée sur l'énergie : il mesure le volume sur de courtes trames, repère les passages calmes et supprime les plus longs. Ce n'est ni de la reconnaissance vocale ni de l'IA, donc l'outil ne distingue pas la parole des autres sons. La musique, les applaudissements, les respirations et un bruit de fond constant peuvent garder des zones que vous vouliez couper, et une parole très faible peut être supprimée.
Ce qu’il faut fournir et comment ça marche
Joignez un WAV, MP3, M4A (AAC) ou MP4 (vidéo H.264 avec audio AAC), ainsi qu'un fichier de sous-titres SRT UTF-8 de 2 Mo maximum si vous le souhaitez. Choisissez un préréglage (prudent, standard ou agressif) ou demandez un seuil fixe en dB, une estimation automatique du bruit de fond, une durée minimale de silence, une marge avant et après chaque partie conservée ou une durée minimale de partie conservée. Les fichiers peuvent atteindre 100 Mio. Un WAV peut durer jusqu'à 30 minutes. L'audio des MP3, M4A et MP4 est décodé en mono 16 kHz et limité à environ 26 minutes (1 562,5 s).
Tout se passe dans le chat Capafy. L'agent ne demande que ce qui manque, prépare et valide les réglages du travail, lance les scripts fournis et résume le résultat. On ne vous demande jamais d'installer un logiciel, d'ouvrir un terminal ou de taper des commandes.
Fichiers reçus et exemple de résultat
Fichiers fournis : cut-list.csv (plages conservées et supprimées en échantillons exacts, secondes et timecode), cut.edl (format EDL courant), cut.fcpxml, keep-only.wav (parties conservées raccordées par des fondus de 5 à 15 ms, PCM 16 bits), waveform.png avec les zones supprimées marquées, timeline.png, report.json et report.md, ainsi que shifted.srt si vous fournissez des sous-titres (les sous-titres entièrement dans une partie supprimée sont retirés). Pour une entrée MP4, vous recevez aussi cut.mp4 (H.264 + AAC, réencodé pour des coupes exactes) uniquement si la vidéo respecte ces limites : classe 640x360 ou moins (grand côté jusqu'à 640, petit côté jusqu'à 360, dimensions paires), 300 secondes maximum, 16 Mio maximum, fréquence d'images constante de 10 à 30 i/s, sans rotation. Au-delà, vous recevez seulement la liste de coupes, l'EDL, le FCPXML et l'audio, avec un message clair. Les vidéos 720p et 1080p ne donnent pas de MP4 coupé.
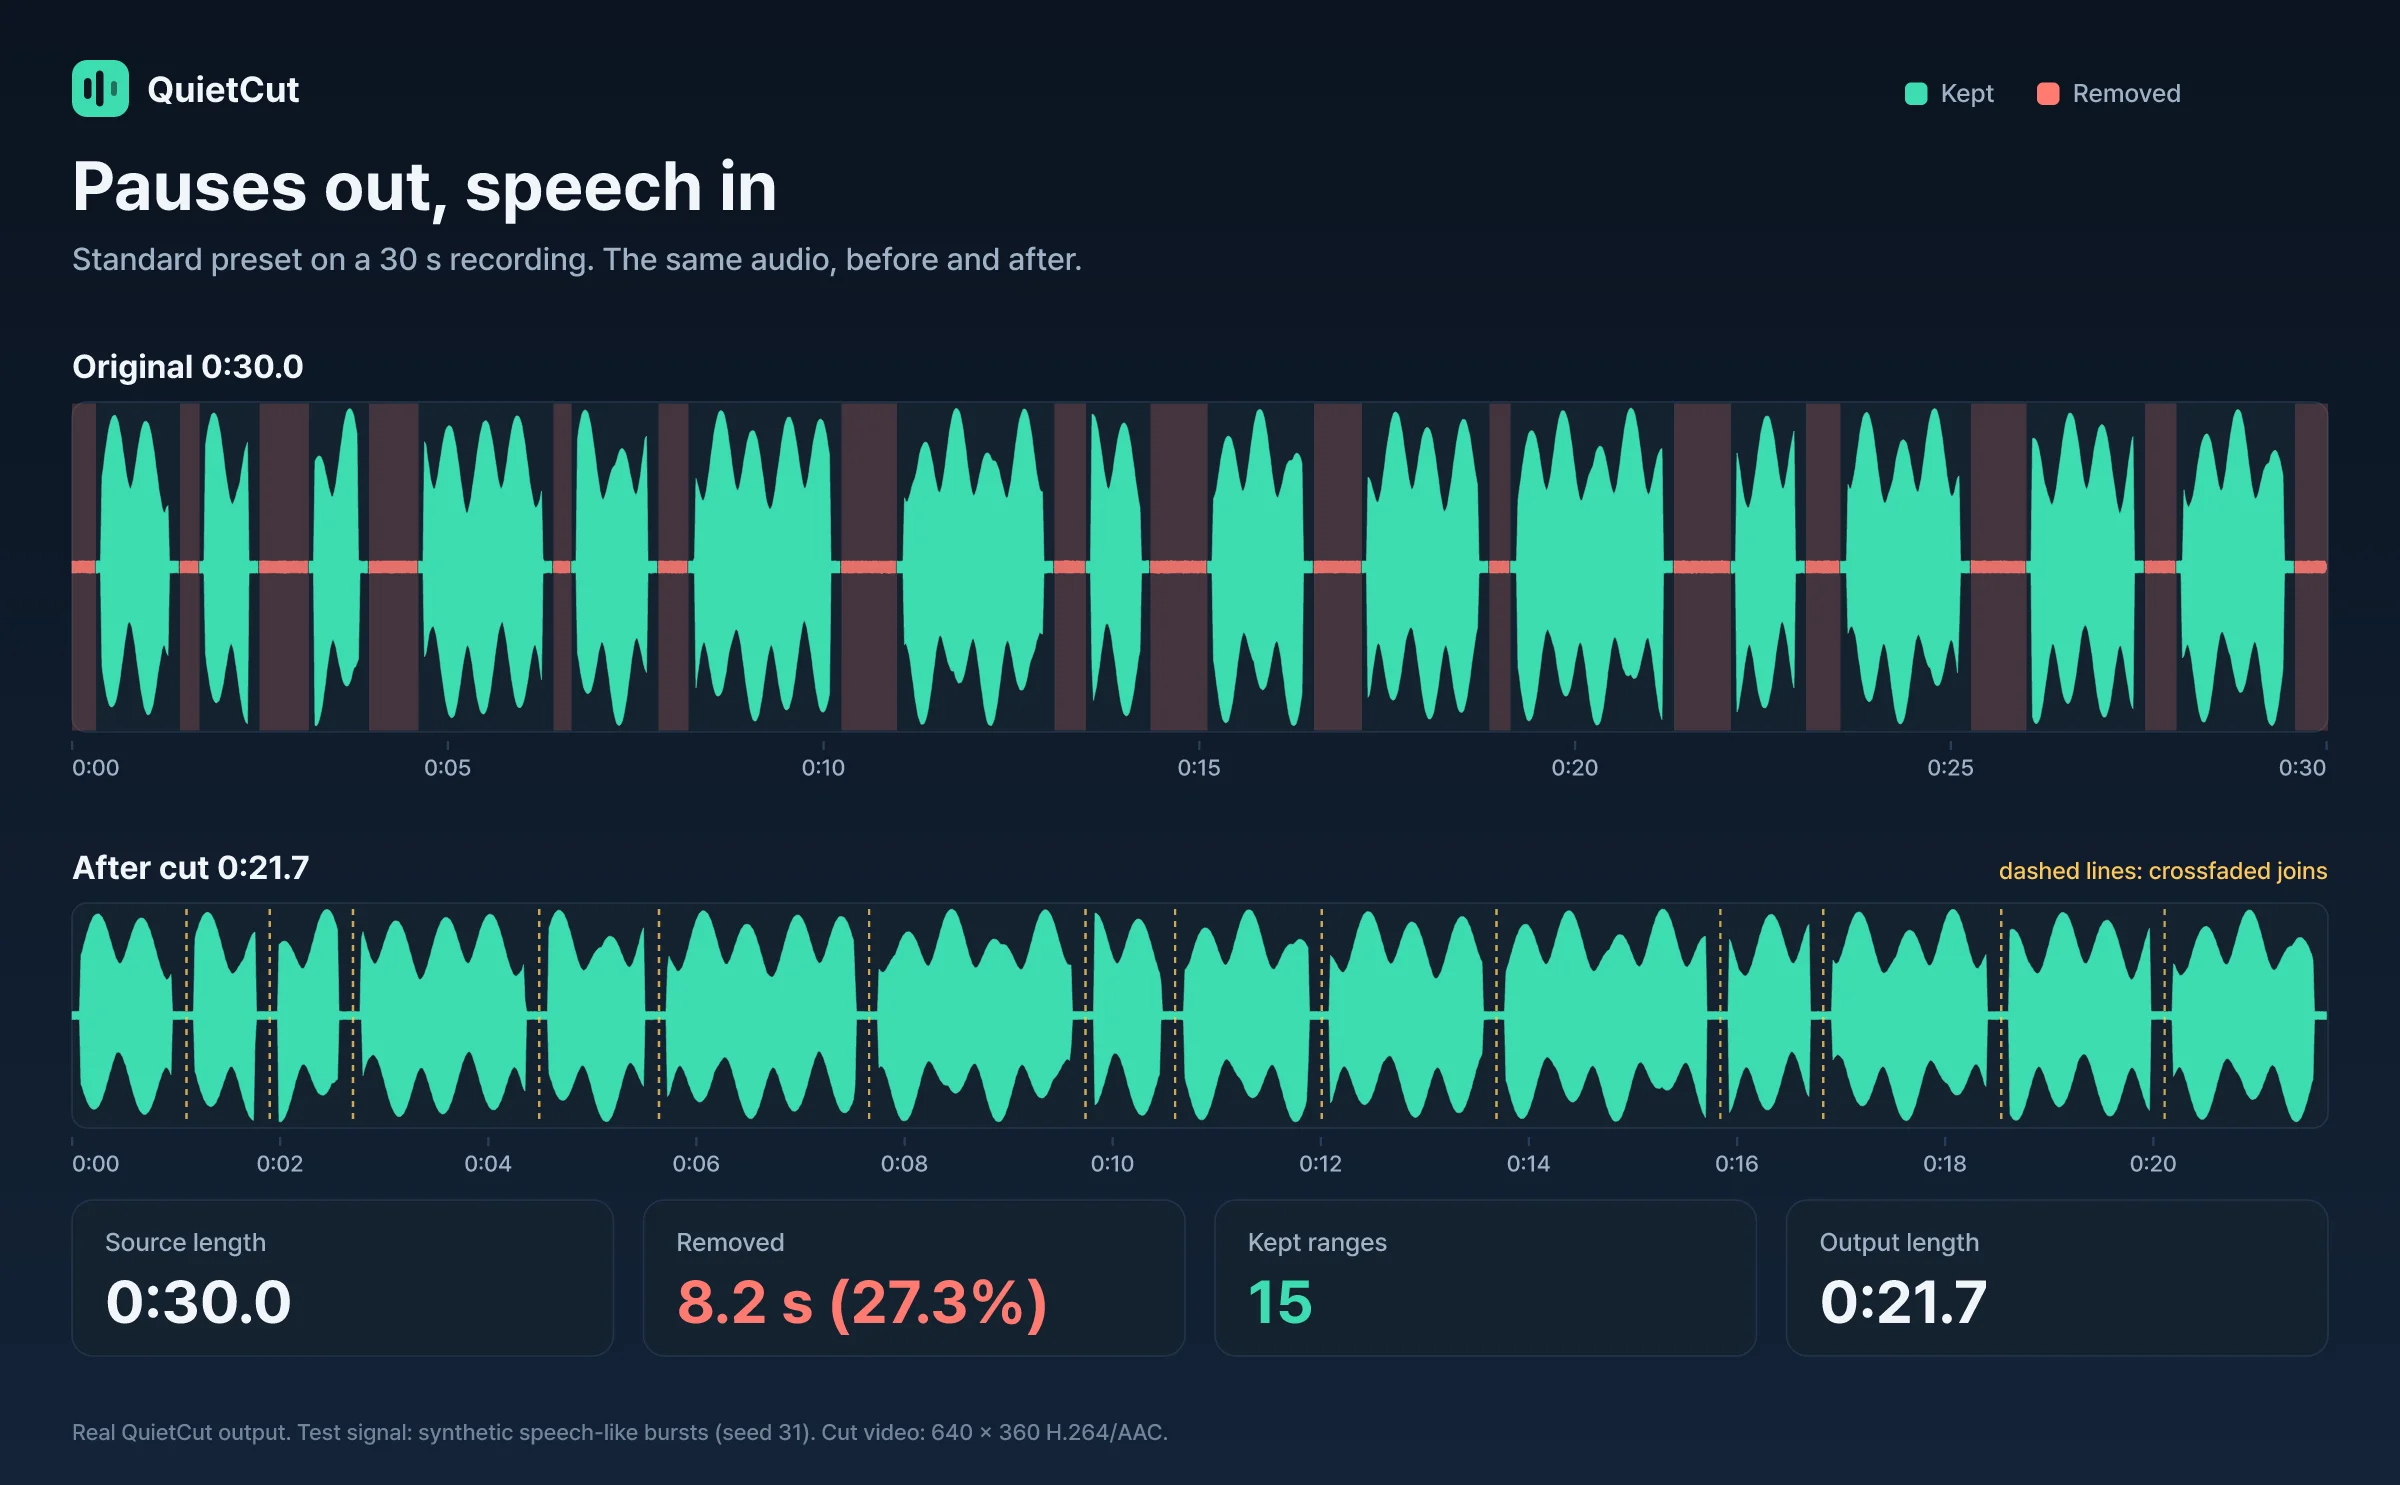
Résultat réel du skill à partir d’une entrée d’exemple (signal de test synthétique), image 1 sur 6.
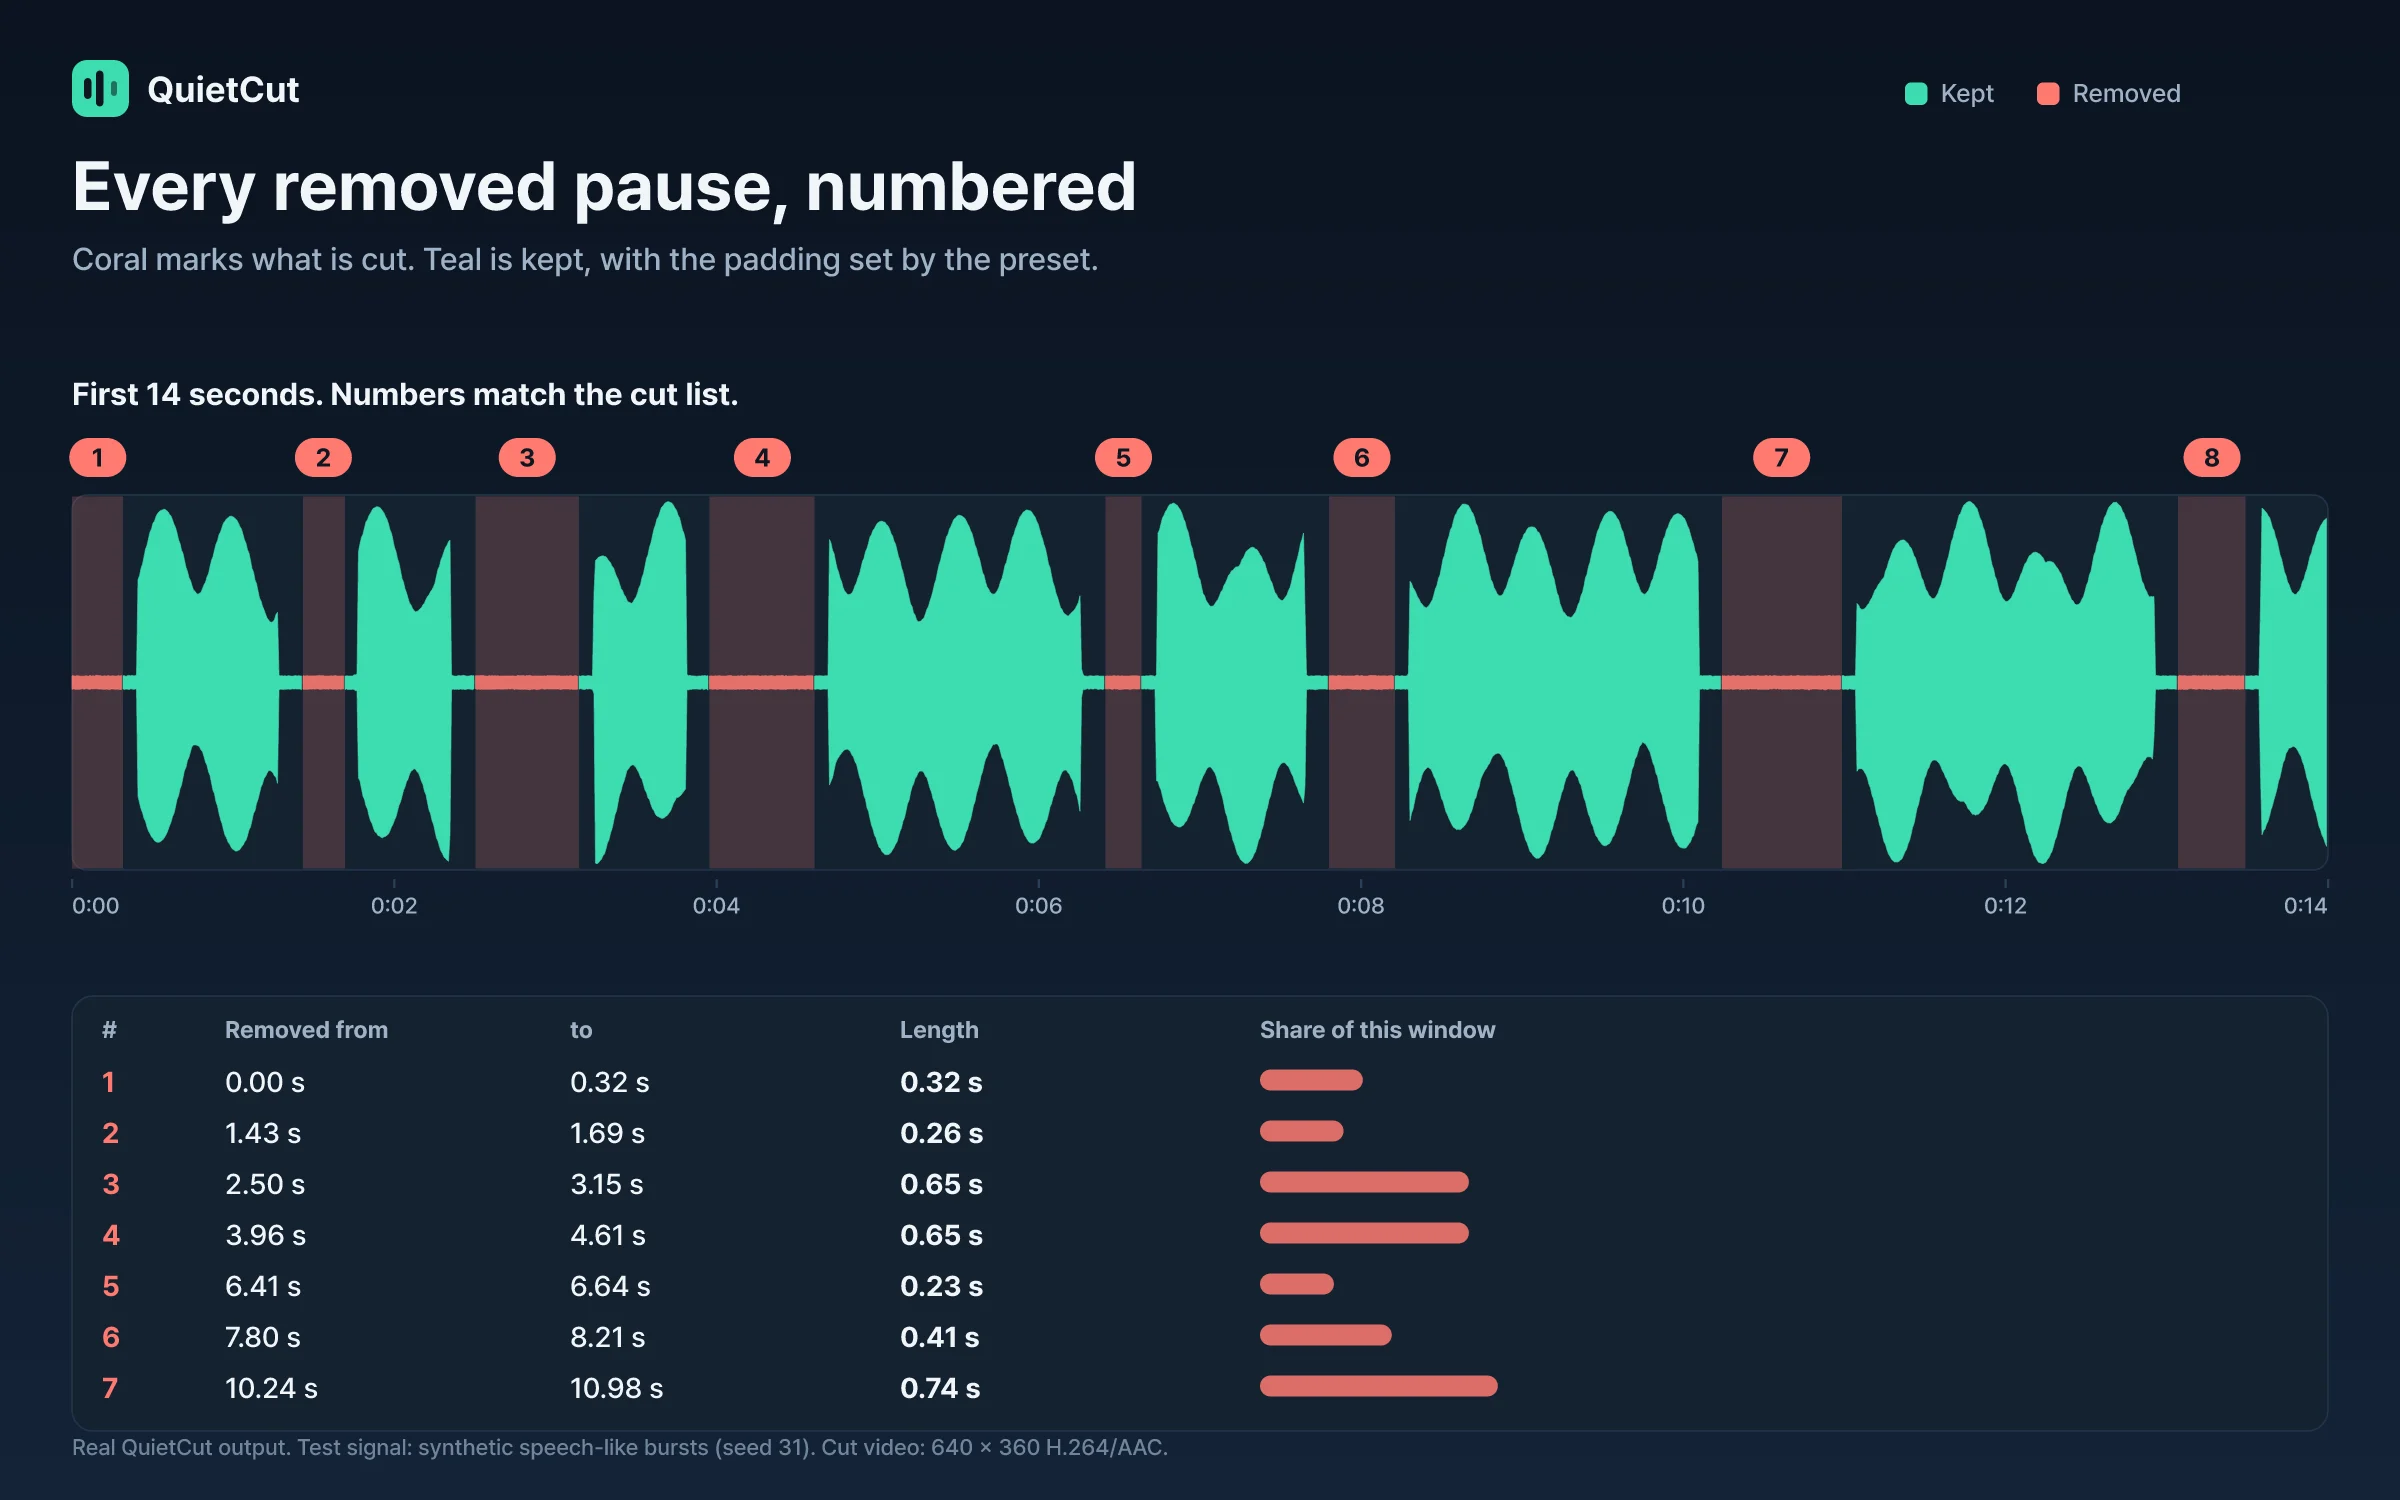
Résultat réel du skill à partir d’une entrée d’exemple (signal de test synthétique), image 2 sur 6.
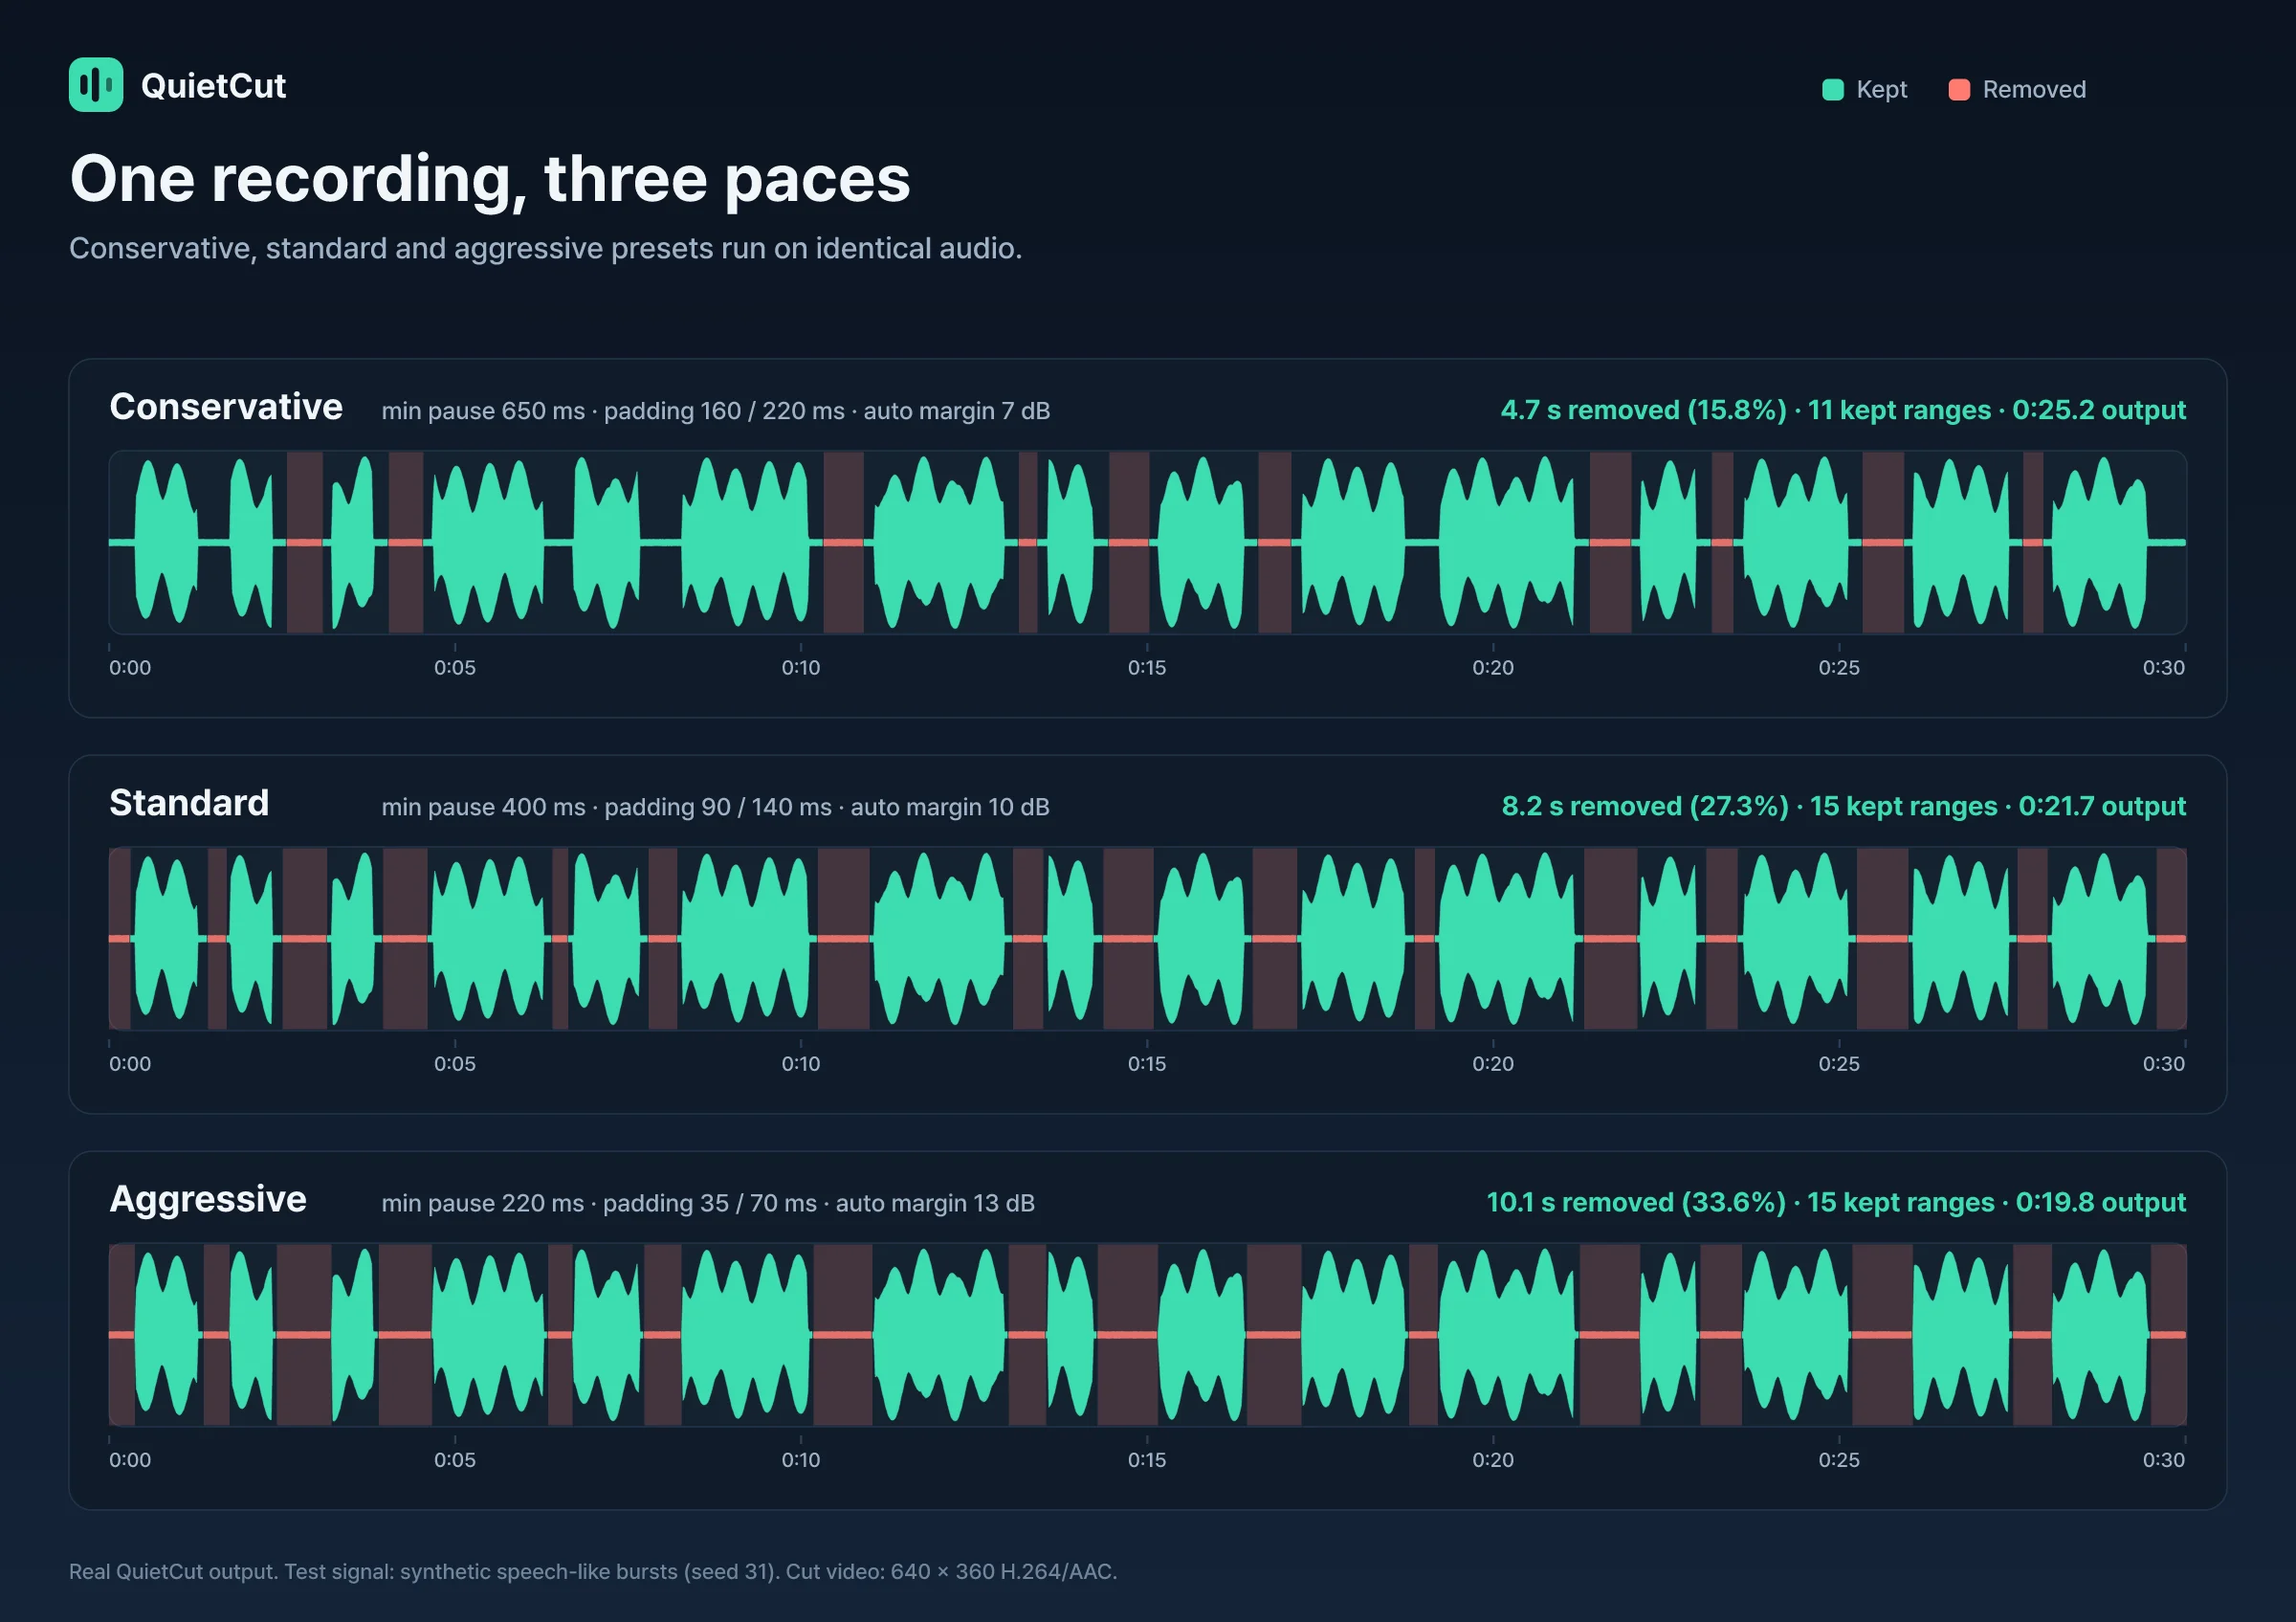
Résultat réel du skill à partir d’une entrée d’exemple (signal de test synthétique), image 3 sur 6.
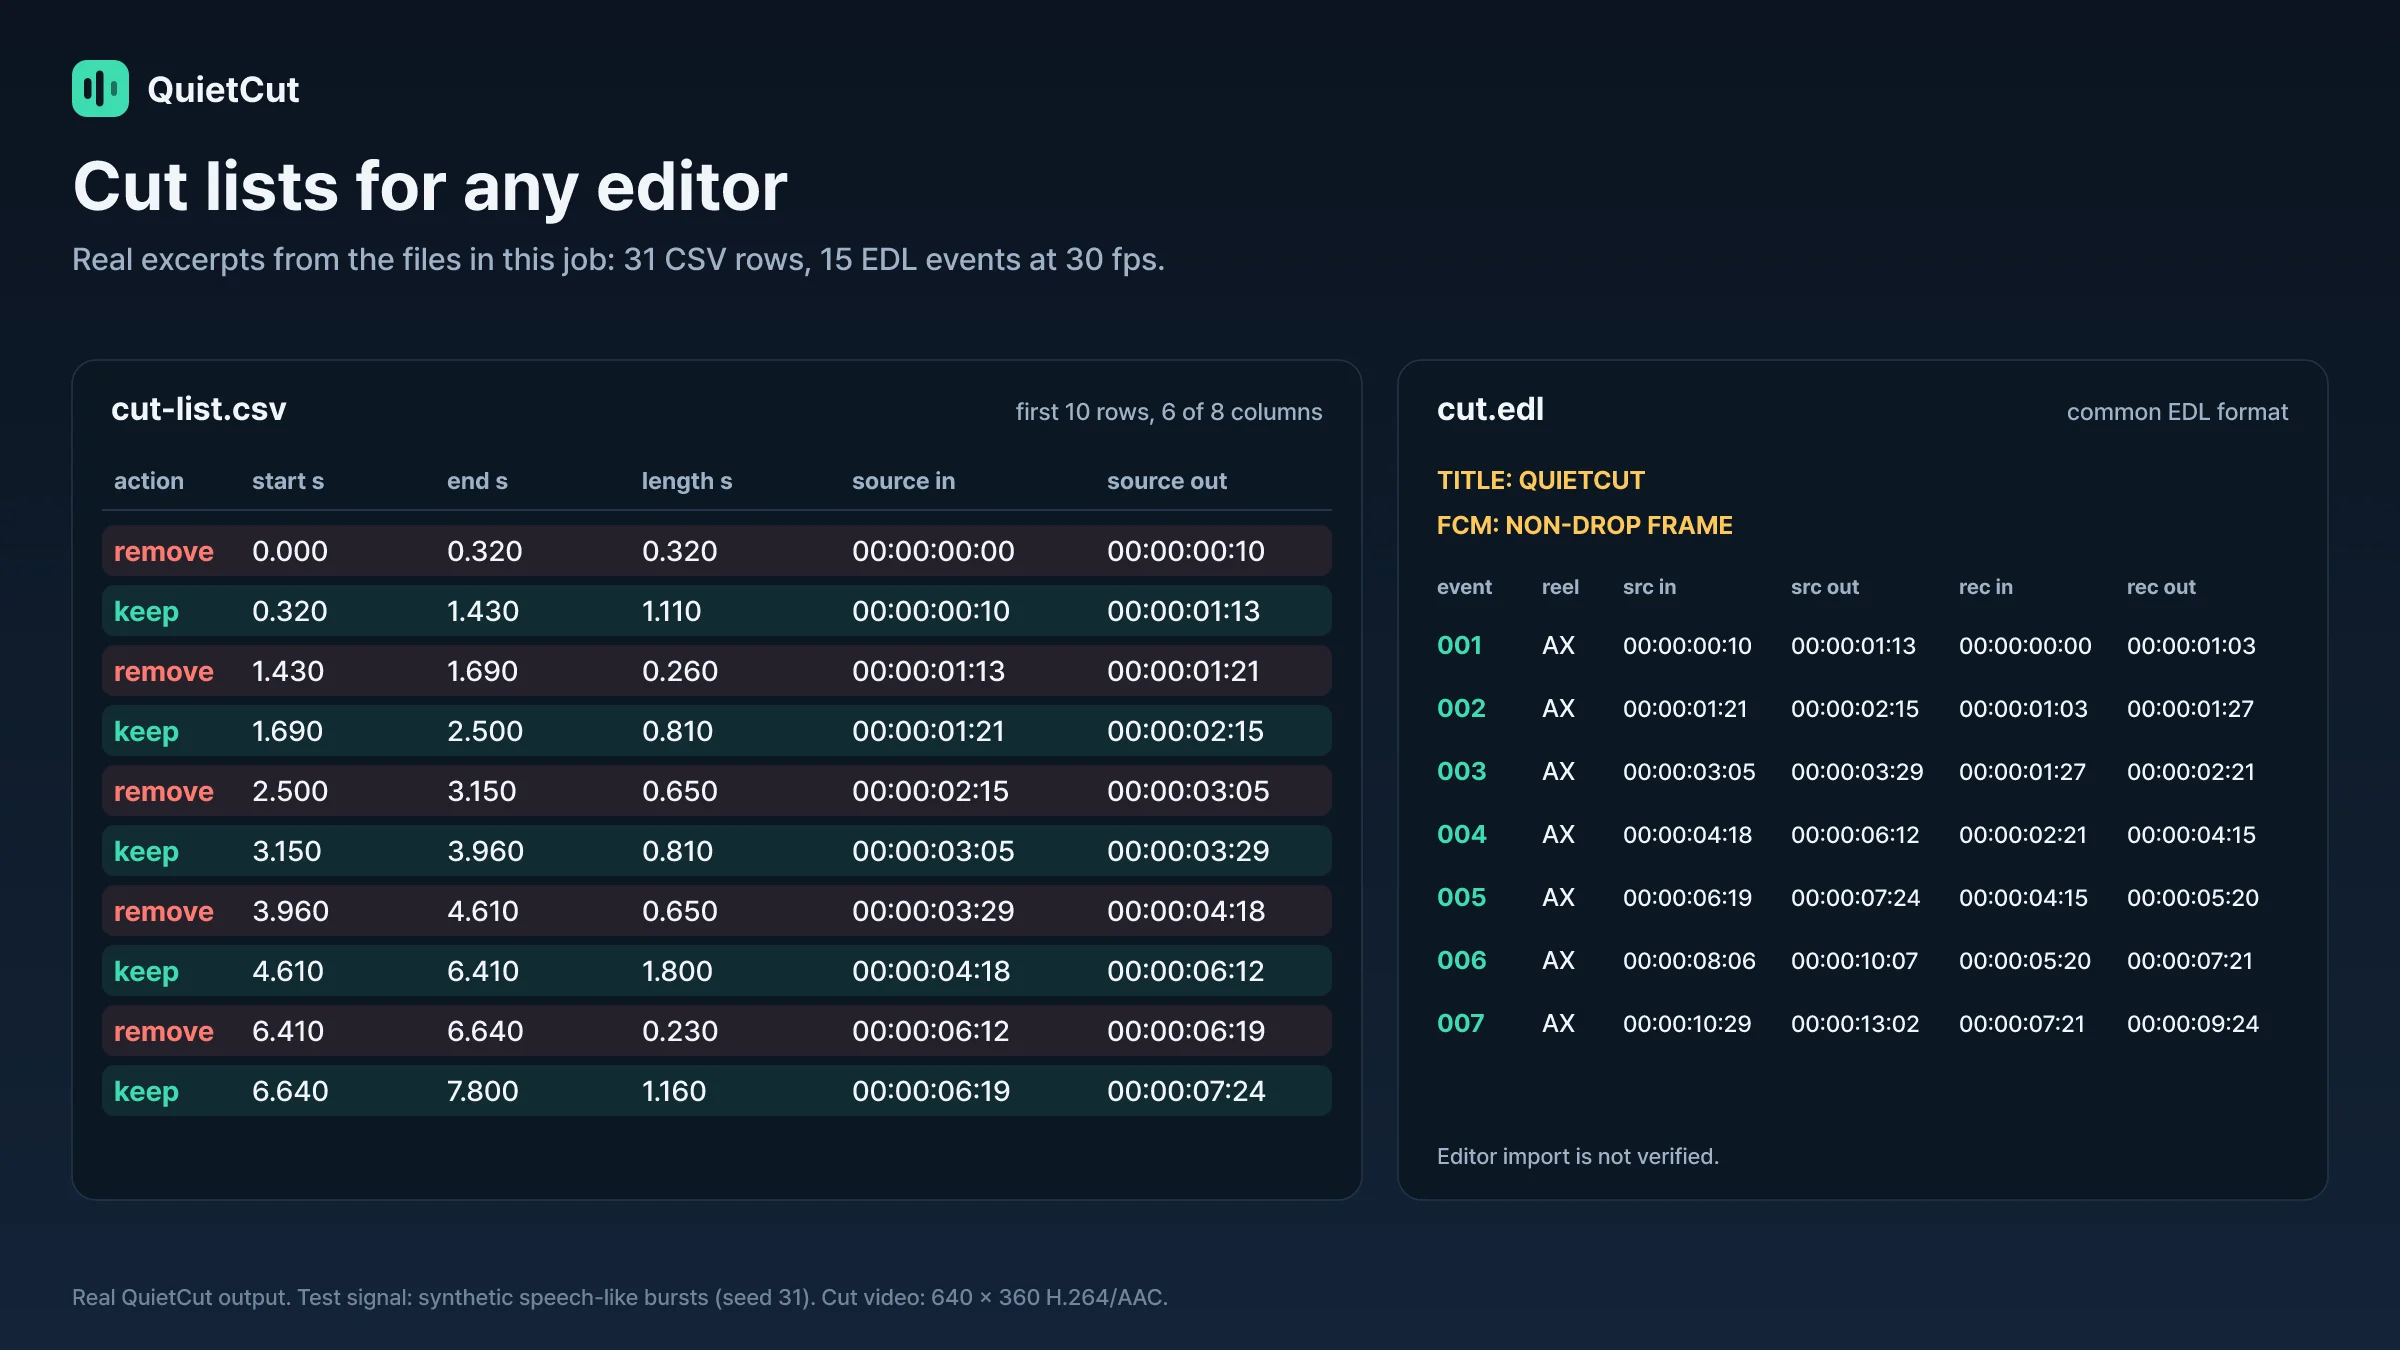
Résultat réel du skill à partir d’une entrée d’exemple (signal de test synthétique), image 4 sur 6.
Vérifications et rapport
Contrôles réellement exécutés : les fichiers sont analysés et les erreurs (format, codec, durée, taille, piste audio absente) sont expliquées simplement. Après chaque travail, une vérification contrôle le nombre de trames et la fréquence du WAV, que le CSV couvre la source sans trou, le nombre de montages de l'EDL et la structure du FCPXML ; pour cut.mp4, elle contrôle que la durée correspond à celle du WAV et que l'écart entre audio et vidéo reste sous 0,1 s. Le rapport indique la durée totale, le temps et le pourcentage supprimés, le nombre de segments, la sonie, un histogramme des durées de silence et des avertissements (plus de 75 % supprimé, parties très courtes, plus d'audio).
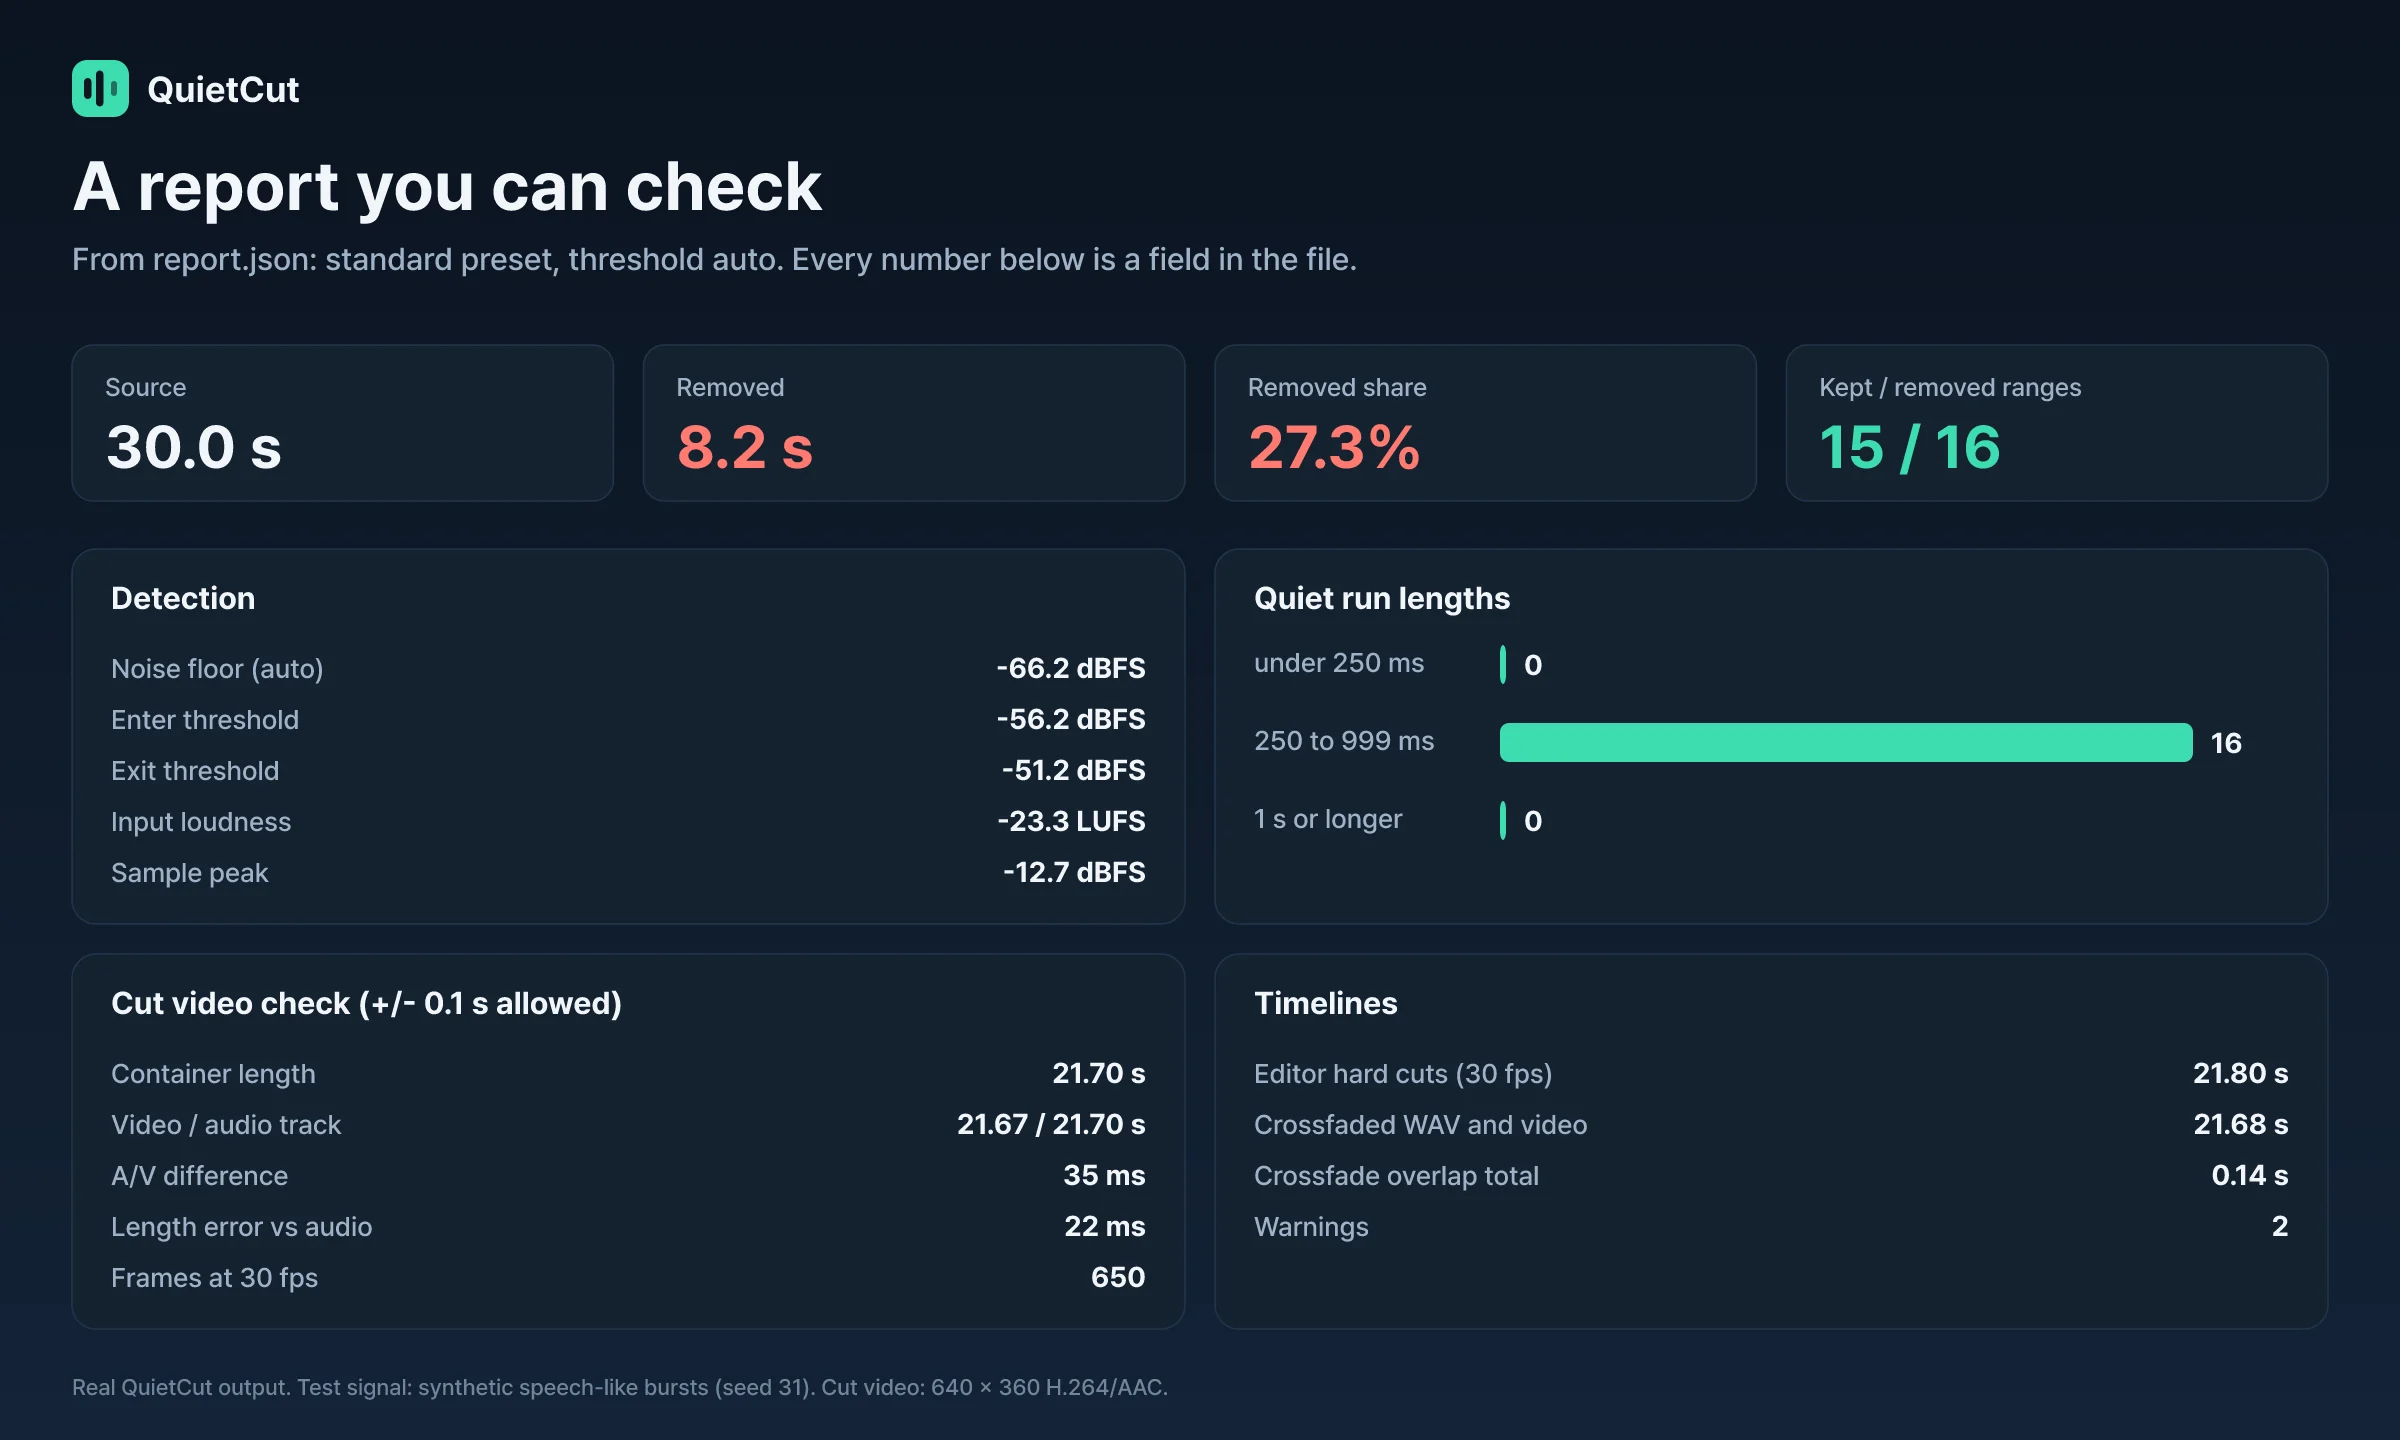
Résultat réel du skill à partir d’une entrée d’exemple (signal de test synthétique), image 5 sur 6.
Précision et vitesse
Précision mesurée sur des signaux synthétiques uniquement : 12 graines, 60 salves connues proches de la parole, silence minimal de 200 ms, sans marge. Précision de 99,2 %, rappel d'environ 100 %, erreur moyenne de frontière de 4,5 ms, maximale de 9,9 ms. Les cas difficiles sont moins bons. Avec un bruit de pièce constant ou de la musique, la précision tombe à environ 54 % (rappel de 100 %), car le bruit est conservé comme s'il s'agissait de parole. Claquements intermittents : précision de 77,5 %. Longues respirations : 74,7 %. Parole chuchotée : précision de 98,9 %, mais rappel d'environ 47 % seulement, donc la parole faible est perdue. Ces chiffres ne décrivent pas votre enregistrement ; vérifiez le résultat et ajustez le seuil.
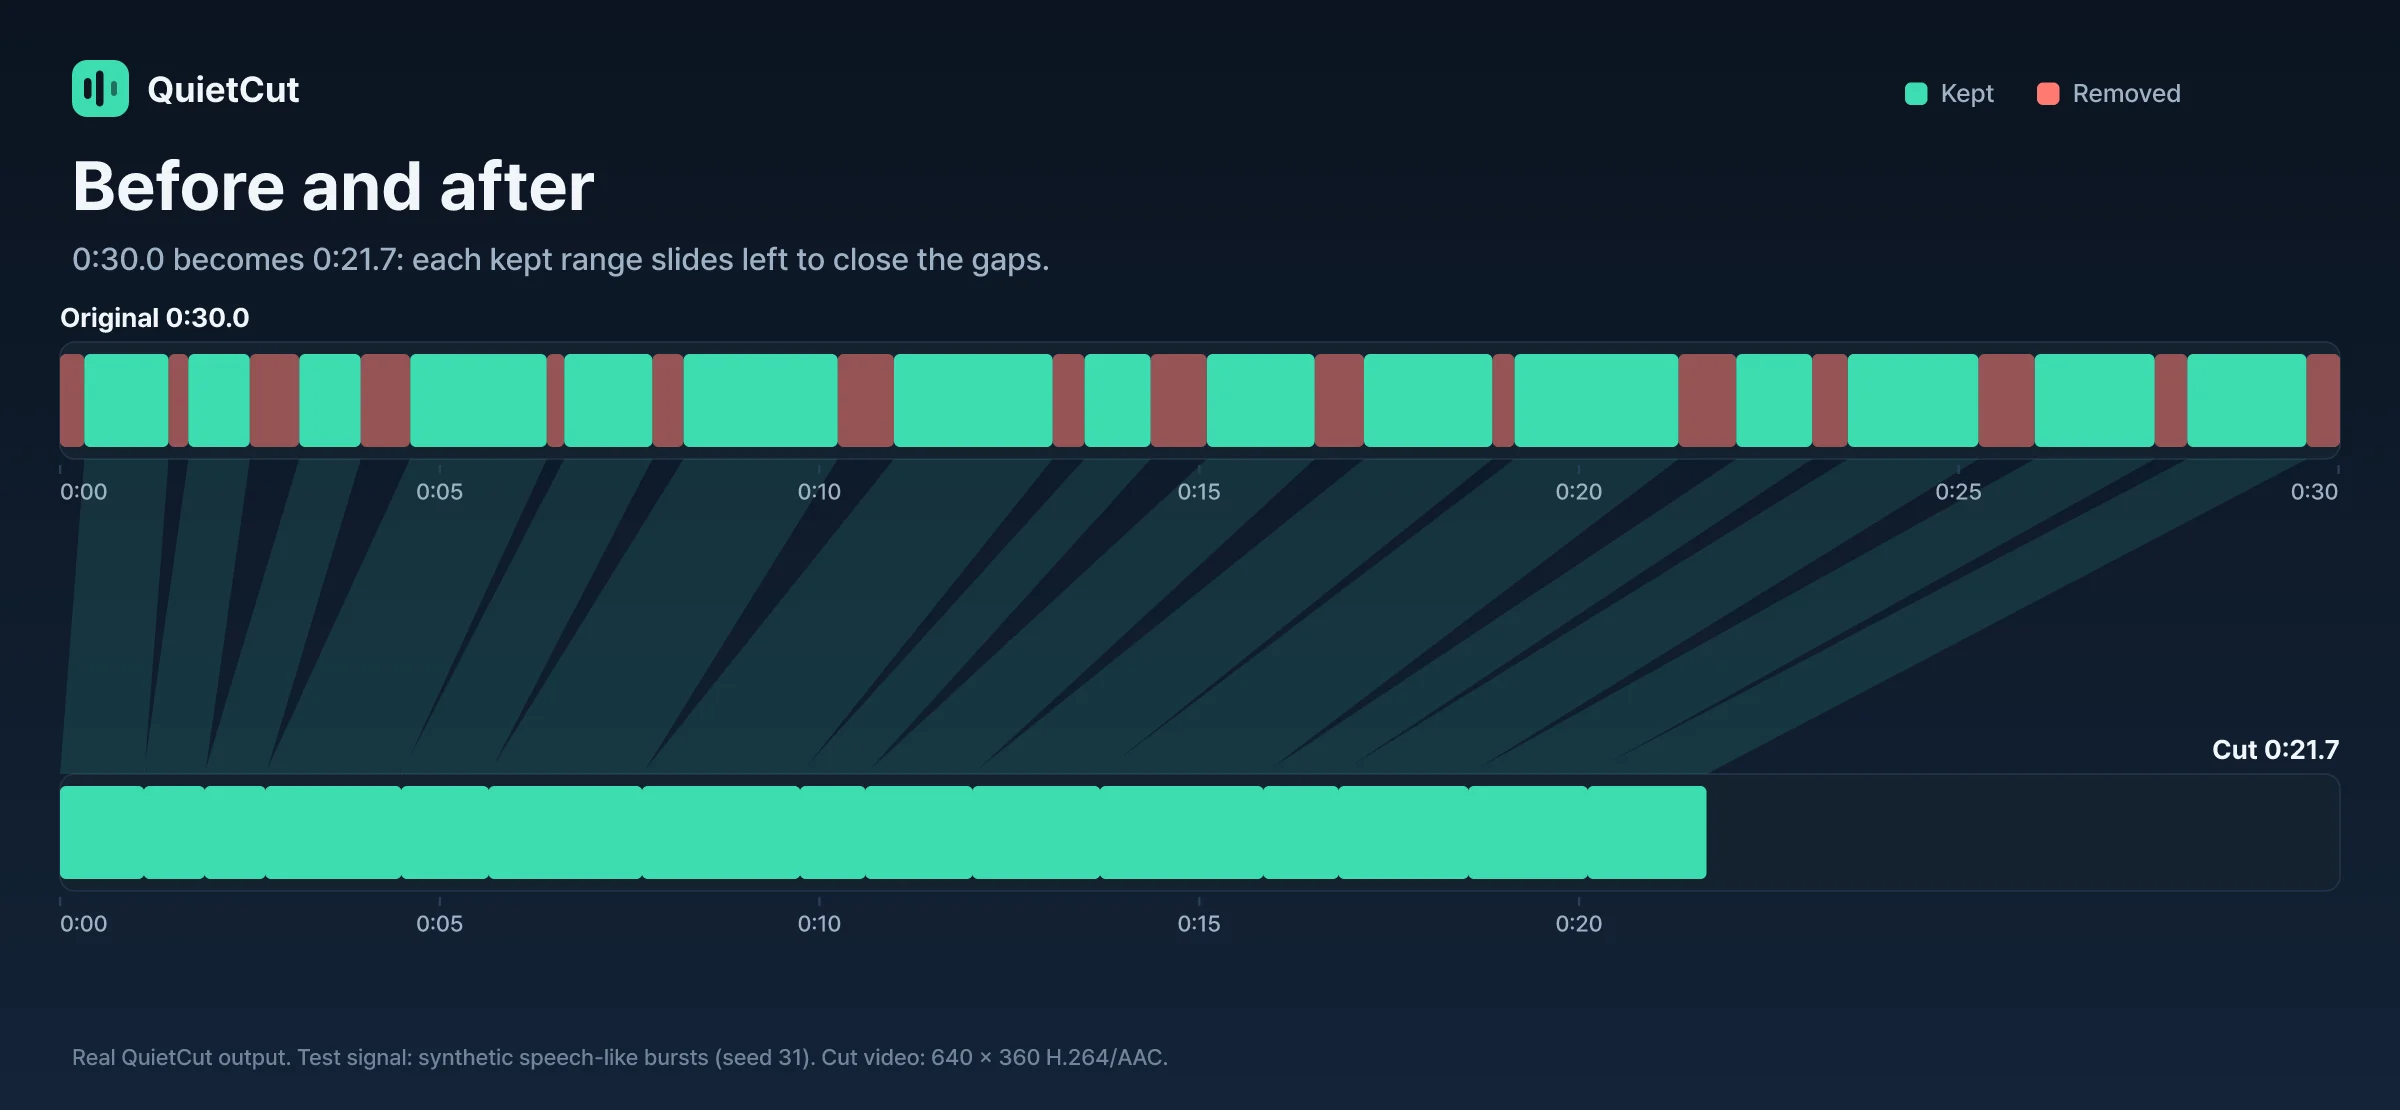
Résultat réel du skill à partir d’une entrée d’exemple (signal de test synthétique), image 6 sur 6.
La vitesse a été mesurée sur un Mac Apple Silicon (arm64) avec Node 26. Un travail sur un WAV de 5 minutes a pris environ 0,13 s. Une vidéo 640x360 de 60 s a pris environ 10 s, et une vidéo de 300 s sans rien supprimer environ 95 s. La vitesse et la mémoire dans le cloud de Capafy ne sont pas vérifiées ; attendez-vous à plus lent. L'import de l'EDL et du FCPXML dans les logiciels de montage n'est pas vérifié ; les deux décrivent des coupes franches arrondies à 24, 25 ou 30 i/s, et le FCPXML renvoie au nom de votre fichier d'origine, que vous devrez peut-être reconnecter.
Traitement des données et forfaits
Traitement des données : le code du produit n'effectue aucun appel réseau ; les fichiers sont lus et écrits dans l'espace de travail Capafy. Ce n'est pas la politique de conservation de Capafy. Vous êtes responsable des droits sur les enregistrements que vous traitez. Les images d'exemple sont de vrais résultats de cette compétence à partir de signaux de test synthétiques, pas des enregistrements de clients.
Formules : hebdomadaire US$4.99 pour 15 travaux. Mensuelle US$9.99 pour 50 travaux. Pas d'essai gratuit.