対談・ライブからショート動画:2人を上下に並べた字幕つき縦動画(ポルトガル語・スペイン語向け)
ポッドキャスト・ライブ・対談番組から、完成した切り抜きを作ります。ポルトガル語とスペイン語を主役に作りました。横に並んだ2人を上下に並べ、字幕は真ん中の帯に置きます。アクセント記号(ã・ç・ñ・¿)も正しく出る1語ずつの字幕、強い言葉の伏せ字も選べます。各クリップに題名・説明文・ハッシュタグ・「元の回はこちら」の一行つき。1回で9:16のMP4を5〜8本。
#動画#ソーシャルメディア
評価
さらに評価が必要です
販売数
0
利用方法
Capafy で実行
外部アプリでも利用可能
パブリッシャー提供
Claude Sonnet 5
対談番組の切り抜きを、そのまま投稿できる形で
ポルトガル語とスペイン語を主役に作りました。やってくれることは3つです。
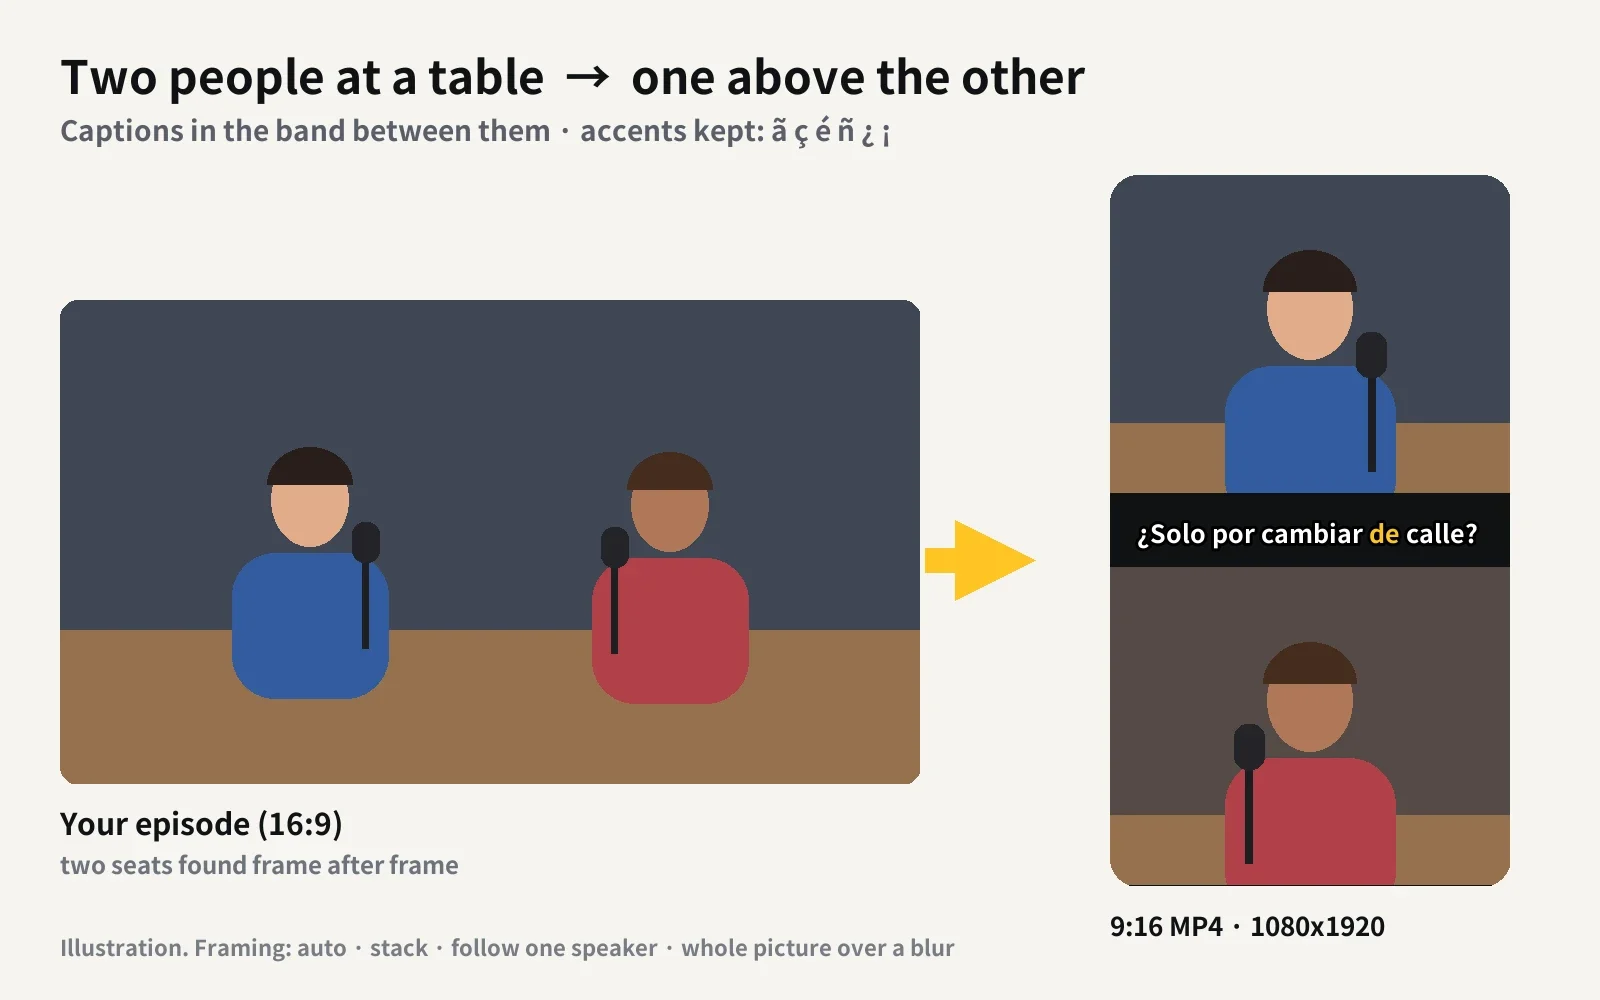
- 横に並んだ2人を上下に並べます。 引きのカメラ1台で撮った対談なら、縦画面の上半分と下半分に1人ずつ。字幕は真ん中の帯に置くので、顔にかかりません。
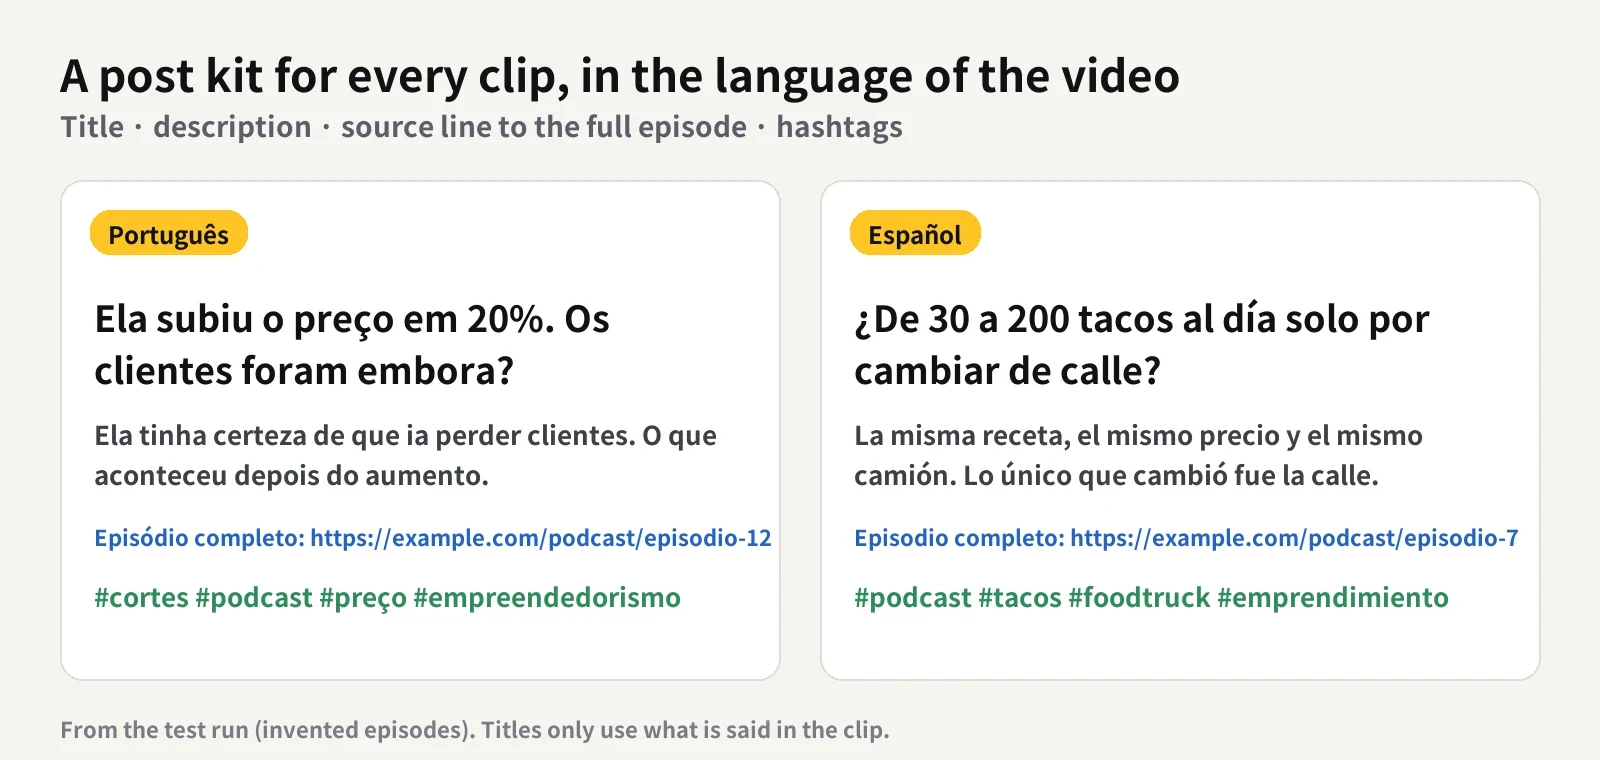
- 各クリップに投稿の一式(動画の言語で): 続きが見たくなる題名(作り話はしません)、説明文、ハッシュタグ、「元の回はこちら: <リンク>」の一行。
- アクセント記号が正しく出る字幕(ã・õ・ç・é・ñ・¿・¡)。頼めば強い言葉を伏せ字にします。
クリップごとに受け取るもの
- 完成した9:16のMP4(1080x1920)。TikTok・Reels・YouTube Shorts向け
- 自動のフレーミング: 2人を上下に・映っている人を追う・全体をぼかし背景の上に。指定もできます
- 1語ずつの字幕の焼き込み(文脈を見て校正)と.srtファイル
- アプリの音量にそろえた音
- 投稿の一式をクリップごとのテキストファイルで。全部をまとめたclips.csvと、各クリップが回のどこにあるかの図
送るもの
- 番組の動画: 約50MBまではアップロード。それより大きい時はGoogleドライブかDropboxのファイルのリンク(4GBまで)。
- 長い回: 1回の依頼で読むのは60分まで。部分を指定してください(例: 1:10:00-2:10:00)。別の部分は別の依頼です。
- 元の回のリンク: 各クリップの出どころの一行に入れます。
- 公開YouTubeのリンクだけ: 先に切り抜きの計画と投稿の一式をお返しします(YouTubeからは何もダウンロードしません)。あとからファイルを送ればMP4にします。
- 任意: 本数(指定がなければ5〜8本・最大10本)、長さ、正しく書いてほしい名前、伏せ字の有無。
できないこと
- ご自身の番組、または編集の許可がある動画だけが対象です。 YouTubeやTikTokなどからは何もダウンロードしません。
- 見分けるのは顔で、声ではありません。 誰が話しているかは分かりません。クリップの途中でカメラが切り替わる時は、画面を分けずにふだんのフレーミングにします。
- 字幕は音声認識によるものです。 投稿前に一度読んでください。伏せ字は文字だけで、音は変わりません。
- 再生数は約束しません。
外部との通信
初回の実行時にPyPIからソフトウェア、Hugging Faceから公開の音声モデルをダウンロードします。動画と音声はこれらに送りません。文字起こしの文章と確認用のコマは、このエージェントを動かすAIモデルが読みます。YouTubeのリンクを貼った場合は、リンクだけをGoogleのGemini APIに送ります。
外部API
PyPI · Hugging Face · GitHub · User-provided file link · Google Gemini API