말큐 | 영상 하나가 다국어 자막 완성본이 됩니다
말큐 | 영상 하나가 다국어 자막 완성본이 됩니다
whisper로 자막을 뽑아본 사람은 이 장면을 압니다. 한 문장이 통째로 한 줄에
몰려서 6~7초씩 떠 있고, 줄바꿈은 아예 없고, 짧은 대답("네.", "감사합니다.")은
1초도 안 되게 반짝이다 사라집니다. 번역까지 붙이면 문제가 하나 더 생깁니다.
큐 하나를 실수로 빠뜨리거나 타임코드를 밀려 쓰면 자막 전체가 어긋나는데,
눈으로 한 줄씩 대조하기 전에는 알아채기 어렵습니다. 말큐는 이 두 문제를
각각 스크립트로 처리합니다. 재세그먼트 규칙으로 읽기 편한 큐를 만들고,
번역 가져오기 단계에서 원본과 큐 개수·타임코드를 자동으로 대조해 하나라도
어긋나면 아무 파일도 쓰지 않고 실패시킵니다.
파이프라인
transcribe.py → segment.py → translation.py export → [에이전트 번역] →
translation.py import → burn.py           (모든 단계에서) qc.py
  단어 타임스탬프    재세그먼트                                번인
실제 명령
아래는 41.78초짜리 실제 샘플(핸드드립 커피 설명, 한국어 TTS 음성)을 이
명령 그대로 돌린 결과입니다.
uv run scripts/transcribe.py samples/coffee_handdrip_ko.mp4 --language ko --model small
uv run scripts/segment.py --words out/words.json --out-dir out
uv run scripts/qc.py --cues out/cues.json --lang ko

uv run scripts/translation.py export --cues out/cues.json --langs en,ja --out-dir out/translate
# (에이전트가 worksheet.en.md / worksheet.ja.md 의 [번역] 줄을 채움)
uv run scripts/translation.py import --cues out/cues.json --worksheet out/translate/worksheet.en.md --lang en --out-dir out
uv run scripts/translation.py import --cues out/cues.json --worksheet out/translate/worksheet.ja.md --lang ja --out-dir out

uv run scripts/burn.py --video samples/coffee_handdrip_ko.mp4 --srt out/ko.srt --lang ko \
    --out out/coffee_ko_burned.mp4 --style outline --position bottom
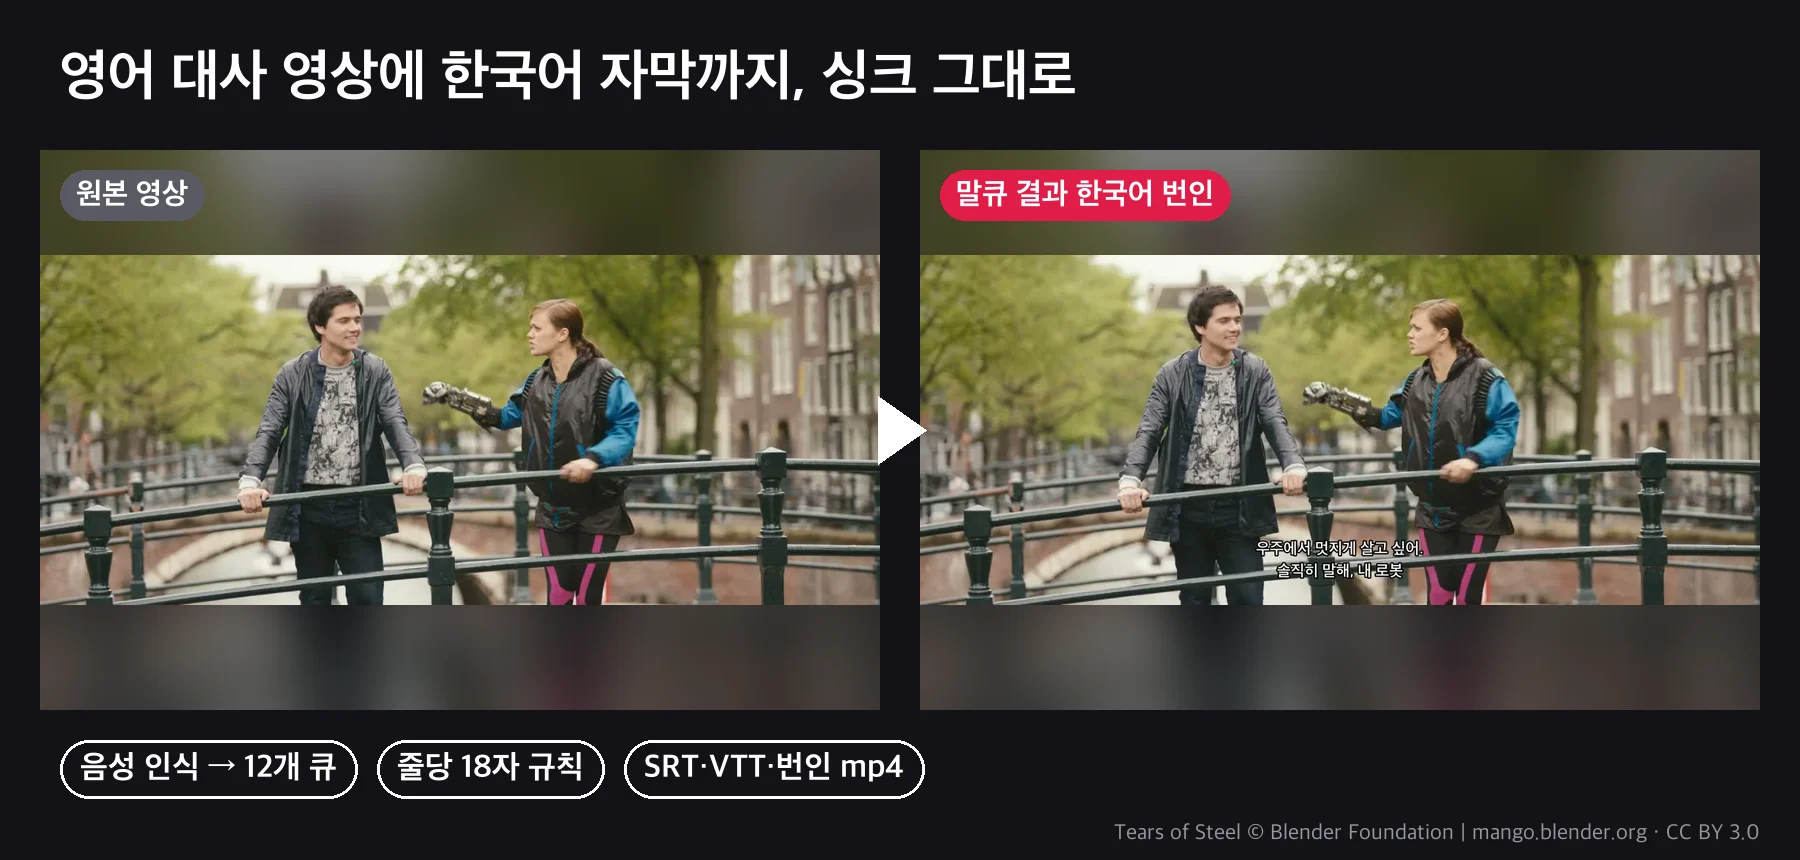
결과: whisper 원시 세그먼트 7개(최대 51자짜리 한 줄)가 재세그먼트 큐
12개(최대 2줄, 줄당 18자 이내)로 바뀌었고, 영어·일본어 자막 모두 큐 12개
검증을 통과했고, 세 언어 모두 QC 결과 위반 0건(PASS)이었습니다. 자세한
수치와 발견한 문제·수정 내역은 E2E.md에 그대로 남겨뒀습니다.
포함 구성
| 파일 | 역할 |
|---|---|
scripts/transcribe.py |
faster-whisper로 단어 단위 타임스탬프 STT |
scripts/segment.py |
줄 길이·CPS·노출시간 규칙으로 재세그먼트, 짧은 큐 병합, 간격 정리 |
scripts/translation.py |
번역 작업지 내보내기/가져오기, 큐 개수·타임코드 대조 검증 |
scripts/burn.py |
Pillow+ffmpeg overlay로 outline/box 스타일 번인 (16:9/9:16 프리셋) |
scripts/qc.py |
줄 겹침·CPS·줄길이·노출시간·간격 검사 리포트 |
guides/style-and-cps-guide.md |
언어별 CPS·줄길이 기본값과 근거, 화면비 프리셋 표 |
guides/translation-workflow.md |
번역 작업지 형식, 검증 실패 케이스별 원인 |
guides/troubleshooting.md |
폰트 탐색 실패, CPS 경고, 긴 영상 성능 등 |
사용 예시
1. 유튜브 강의 원어 자막 다듬기: transcribe.py로 뽑은 뒤segment.py만 돌려도 whisper 자동 자막보다 훨씬 읽기 편한 SRT가
나옵니다. 번역이 필요 없다면 여기서 끝내고 qc.py로 확인만 합니다.
2. 인터뷰 영상을 영어·일본어로 동시 배포: translation.py export로
작업지를 뽑아 에이전트가 두 언어를 한 번에 채우고, import로 각각
검증한 뒤 세 개 언어 SRT를 나란히 내보냅니다.
3. 쇼츠용 세로 영상에 자막 번인: burn.py --aspect 9:16 --position top --style box로 세로 화면 하단 UI(좋아요·공유 버튼)를 피해 상단에
박스 스타일 자막을 굽습니다.
필요한 준비물
ffmpeg/ffprobe(Homebrew 등, 9.x 기준 테스트):overlay,concat
필터가 있는지ffmpeg -filters로 확인하세요.drawtext/subtitles
필터는 쓰지 않습니다(Homebrew 기본 빌드에 freetype/libass가 없어서
애초에 의존하지 않도록 설계했습니다).uv: PEP 723 인라인 의존성이라pip install없이uv run으로
바로 실행됩니다.transcribe.py를 처음 실행할 때 faster-whisper 모델을 내려받으려면
인터넷이 필요합니다(이후 로컬 캐시 재사용, API 키는 아님).- 번역은 이 스크립트 혼자서는 못 합니다: 에이전트(Claude 등)가 작업지
파일을 채워야 합니다. 완전 무인 배치로 번역까지 자동 완성되는 제품은
아닙니다. - 한글이 지원되는 폰트가 시스템에 있어야 번인이 됩니다(macOS/Windows는
자동 탐색, Linux는 Noto Sans CJK 설치를 권장합니다).
추천 대상
- 강의·인터뷰·브이로그를 다국어로 배포하고 싶은데, 번역 자막이 타이밍
어긋나는 사고 없이 정확히 맞길 원하는 크리에이터·에이전시 - whisper로 뽑은 자막이 줄바꿈도 없고 CPS도 안 맞아서 손으로 다시
다듬어야 했던 경험이 있는 편집자
비추천 대상
- 자막 없이 그냥 "영상에서 텍스트만 빨리 뽑고" 싶은 경우: whisper
기본 출력이면 충분합니다(이 스킬은 그 뒤 다듬는 단계가 핵심입니다). - 노래 가사처럼 음절 단위로 정교하게 맞춰야 하는 특수 타이밍 자막,
일반 발화(강의·인터뷰·브이로그) 기준으로 설계했습니다.
FAQ
Q. 번역 API 키가 있어야 하나요?
아니요. 번역은 에이전트(Claude 등)가 작업지 텍스트 파일을 직접 채우는
방식입니다. 스크립트는 그 결과를 검증하고 자막으로 만들 뿐, API를
호출하지 않습니다.
Q. 자막 스타일을 커스텀할 수 있나요?--style outline/box, --position bottom/top, 글자색·테두리색·박스
색상, 폰트·폰트 크기를 CLI 옵션으로 조정할 수 있습니다. 화면비(16:9/
9:16)는 영상 크기로 자동 판단하되 직접 지정도 가능합니다.
Q. 번역문이 원문보다 길어서 화면을 넘치면요?translation.py import가 대상 언어 줄바꿈 규칙으로 자동으로 다시
접고, 그래도 CPS가 넘치면 경고를 띄웁니다. 실제 E2E 테스트에서 영어
번역 한 건이 이 경고에 걸려 번역 분량을 재배분해 해결한 사례가E2E.md에 그대로 남아 있습니다.
Q. 긴 영상(1시간 강의)도 되나요?
STT·재세그먼트·QC는 길이에 크게 구애받지 않습니다. 다만 burn.py는
큐 하나당 ffmpeg 필터를 하나씩 늘리는 방식이라, 큐가 수백 개를 넘는
영상은 구간별로 나눠 여러 번 돌리는 것을 권장합니다(guides/ troubleshooting.md 참고).
Q. 일본어·중국어 줄바꿈은 정말 자연스러운가요?
형태소 분석기를 쓰지는 않습니다. 대신 가타카나 외래어·한자·히라가나처럼
스크립트가 바뀌는 지점을 우선 줄바꿈 후보로 삼아서, 외래어 중간이
잘리는 것 같은 티 나는 실수는 피합니다. 완벽한 형태소 분석 수준은
아니라는 점은 밝혀둡니다.
구매 안내
다운로드한 zip을 풀면 SKILL.md부터 읽고 안내된 순서대로 uv run scripts/... 명령을 실행하면 됩니다. 별도 설치 스크립트나 계정 연동은
없습니다.
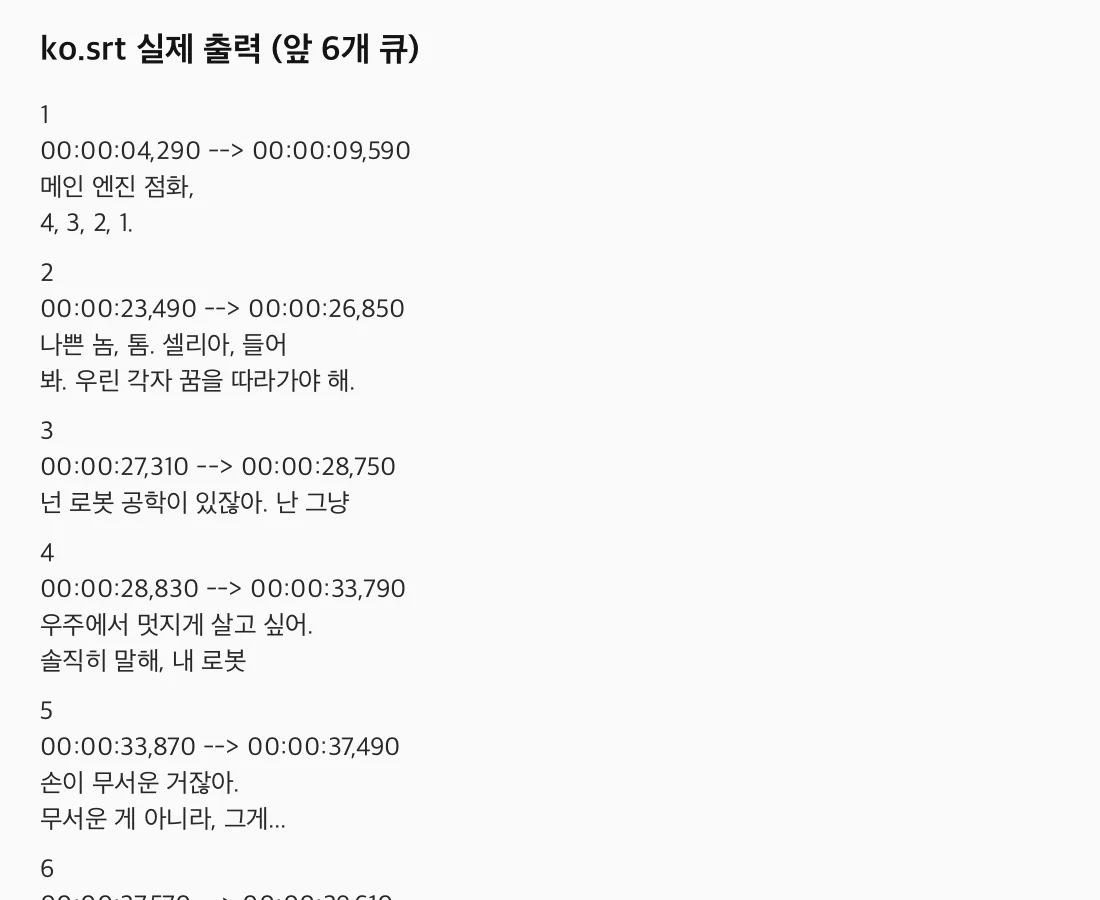
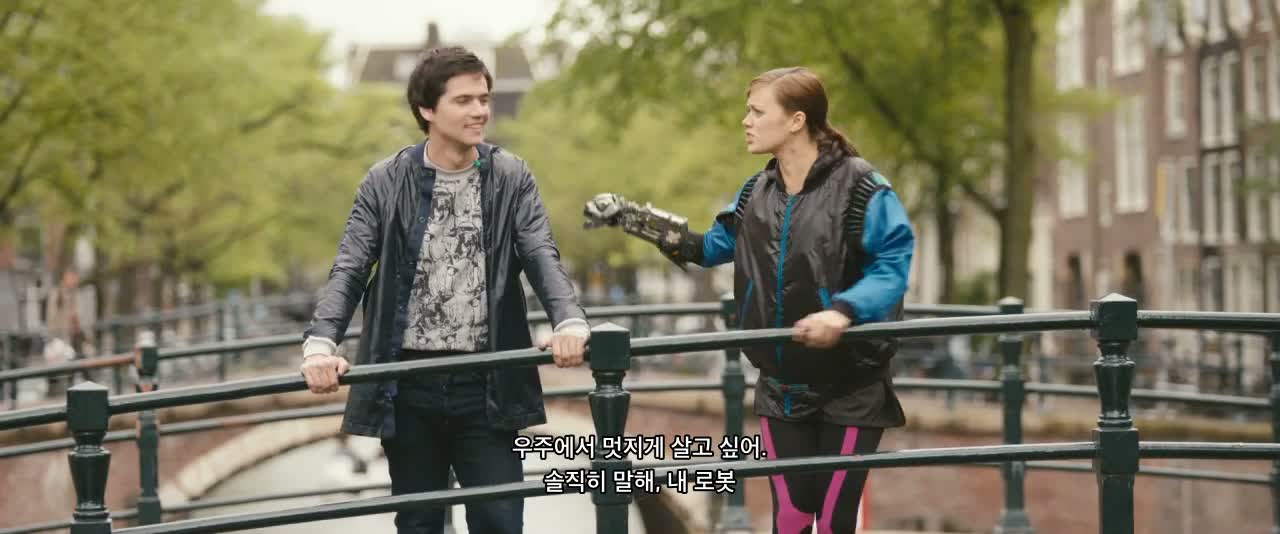
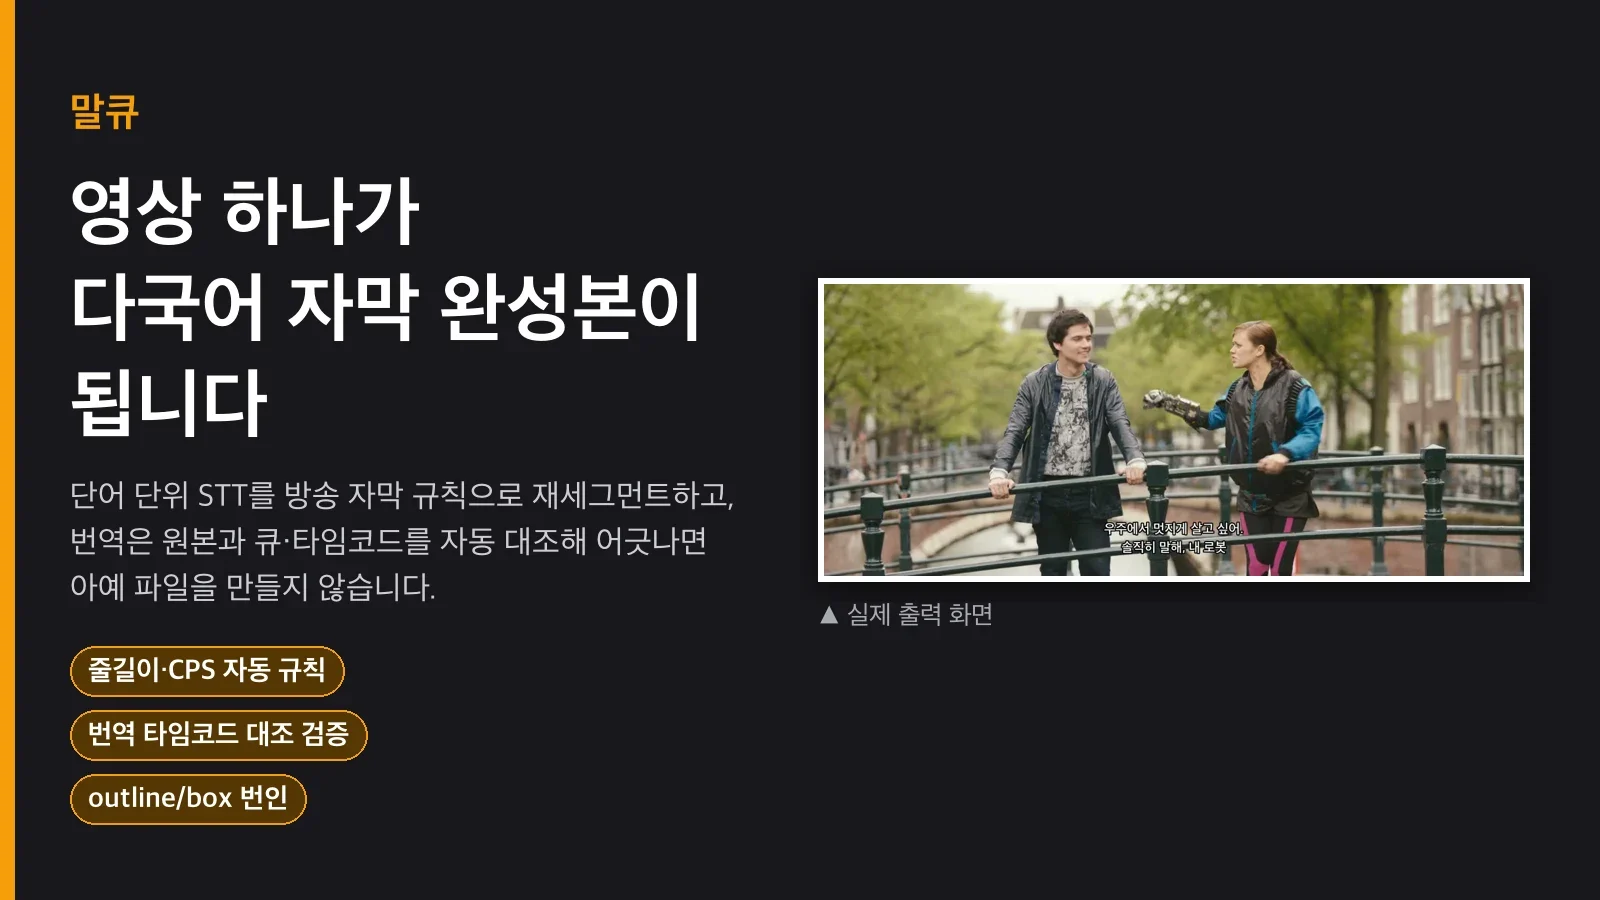
예시 이미지는 Blender Foundation 의 오픈 무비 Tears of Steel(CC BY 3.0, mango.blender.org) 도입부 70초로 실제로 돌린 결과입니다. 한국어 번역은 워크시트 방식으로 에이전트가 채웠고, 음성 인식이 'Jerk, Thom'을 'Dirk, Tom'으로 잘못 들은 부분은 번역 단계에서 바로잡았습니다.