
말큐 클라우드 | 영상 올리면 자막 파일과 자막 입힌 영상이 나옵니다
말큐 클라우드 | 영상 올리면 자막 파일과 자막 입힌 영상이 나옵니다
자막 한 편 만드는 일은 받아쓰기에서 끝나지 않습니다. 문장이 6~7초짜리 두세 줄로 한꺼번에 뜨면 읽다가 놓치니 큐를 다시 나눠야 하고, 번역하면 글자 수가 늘어 또 맞춰야 하고, 마지막에 영상에 입히는 일이 남습니다. 20분짜리 영상이면 반나절입니다.
말큐 클라우드는 이 순서를 한 번에 처리합니다. 채팅에 영상을 올리고 "자막 만들어줘"라고 쓰면 SRT, VTT, 자막이 입혀진 MP4 가 같은 대화로 돌아옵니다. Capafy 클라우드에서 돌아가므로 내 컴퓨터에 파이썬이나 ffmpeg 를 깔 필요가 없고, 번역 API 키도 필요 없습니다.
이렇게 씁니다
채팅에 영상을 올리고 한 줄만 쓰면 됩니다.
- "자막 만들어줘."
- "영어랑 일본어 자막도 같이 만들어줘."
- "영어 자막을 영상에 입혀서 줘. 위쪽에 박스로."
- "한 줄이 너무 길어. 14자로 줄여줘."
받는 파일
| 파일 | 내용 |
|---|---|
이름.ko.srt, 이름.ko.vtt |
말하는 언어의 자막. 다른 편집기와 업로드 사이트에 그대로 쓸 수 있음 |
이름.en.srt, 이름.en.vtt |
요청한 번역 언어마다 한 쌍 |
이름.ko.burned.mp4 |
자막을 입힌 영상. 원본 해상도 그대로 H.264/AAC |
summary.md |
언어별 큐 개수와 품질 검사 결과 |
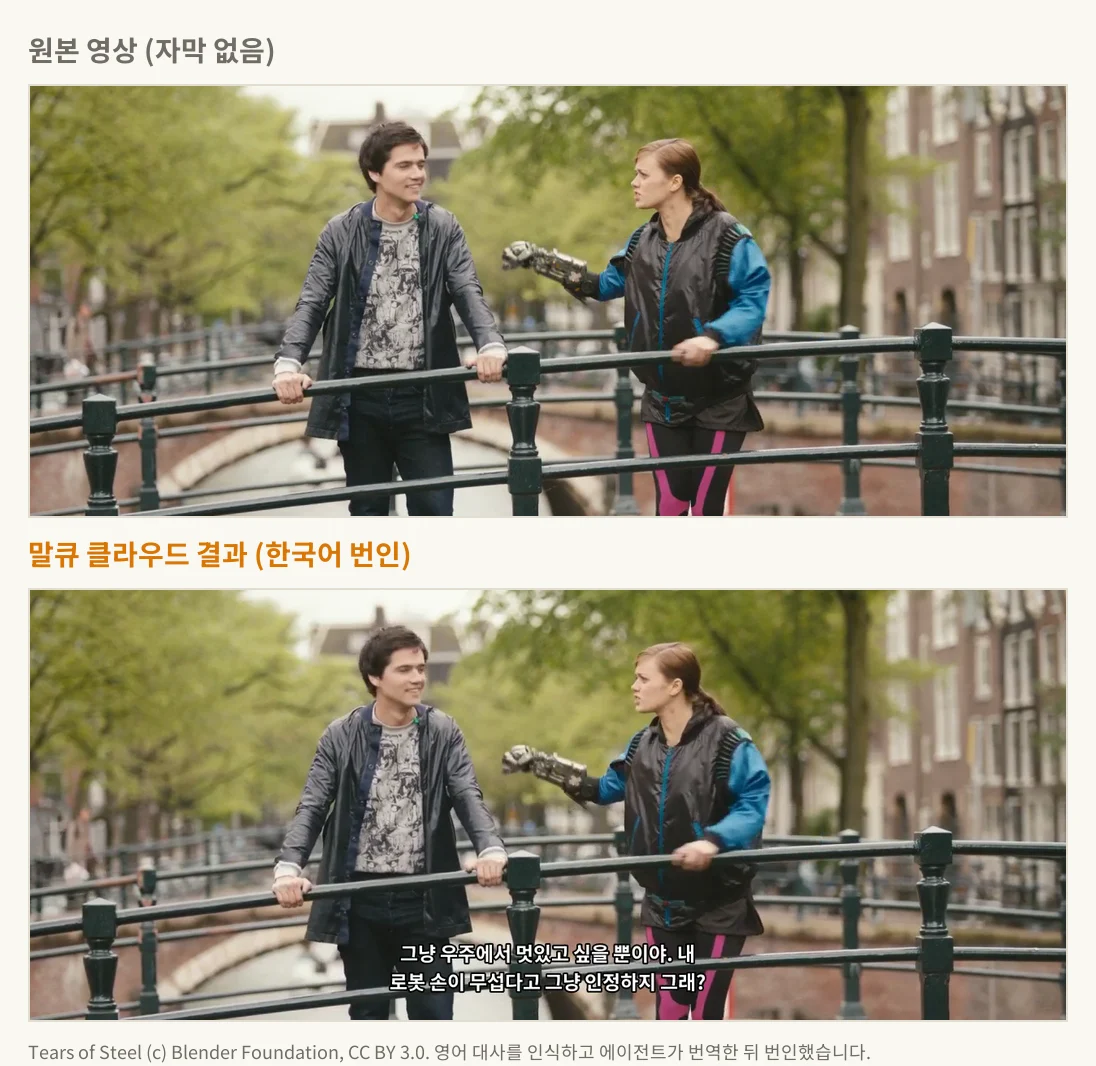
Tears of Steel (c) Blender Foundation, CC BY 3.0. 영어 대사를 인식하고 에이전트가 번역한 뒤 입혔습니다.
처리 순서
업로드 ─► 음성 인식 ─► 큐 재구성 ─► 품질 검사 ─► 번역(에이전트) ─► 대조 검증 ─► 번인 ─► 파일 전달
         단어별 시각    줄 수·글자 수   겹침·빈 큐    작업지를 직접      큐 수·번호·       글자 PNG를
         (faster-whisper) 초당 글자 수    CPS·간격     채움             타임코드 비교     영상에 겹침
- 음성 인식. faster-whisper 로 단어마다 시작과 끝 시각을 받습니다. 언어는 자동으로 감지합니다.
- 큐 재구성. 최대 2줄, 한국어 줄당 18자, 초당 17자, 노출 최소 1초에서 최대 7초 기준으로 다시 나눕니다. 줄은 어절 경계에서, 쉼표 뒤를 우선해서 접습니다. 영어는 줄당 42자와 초당 21자, 일본어·중국어는 줄당 16자와 초당 13자가 기준입니다.
- 번역. 번역 API 를 부르지 않습니다. 에이전트가 전체 내용을 읽고 번역 작업지를 채웁니다. 한 문장이 여러 큐에 걸치면 그 흐름을 보고 옮깁니다.
- 대조 검증. 번역 결과의 큐 개수, 번호, 타임코드가 원본과 하나라도 다르면 그 언어 파일은 만들지 않고 어디가 틀렸는지 알려 줍니다.
- 번인. 큐마다 글자 이미지를 그려 영상에 겹칩니다. 흰 글자에 검은 테두리(기본) 또는 반투명 박스를 고르고, 위치는 아래나 위입니다. 세로 영상은 글자 크기와 여백을 따로 잡습니다.
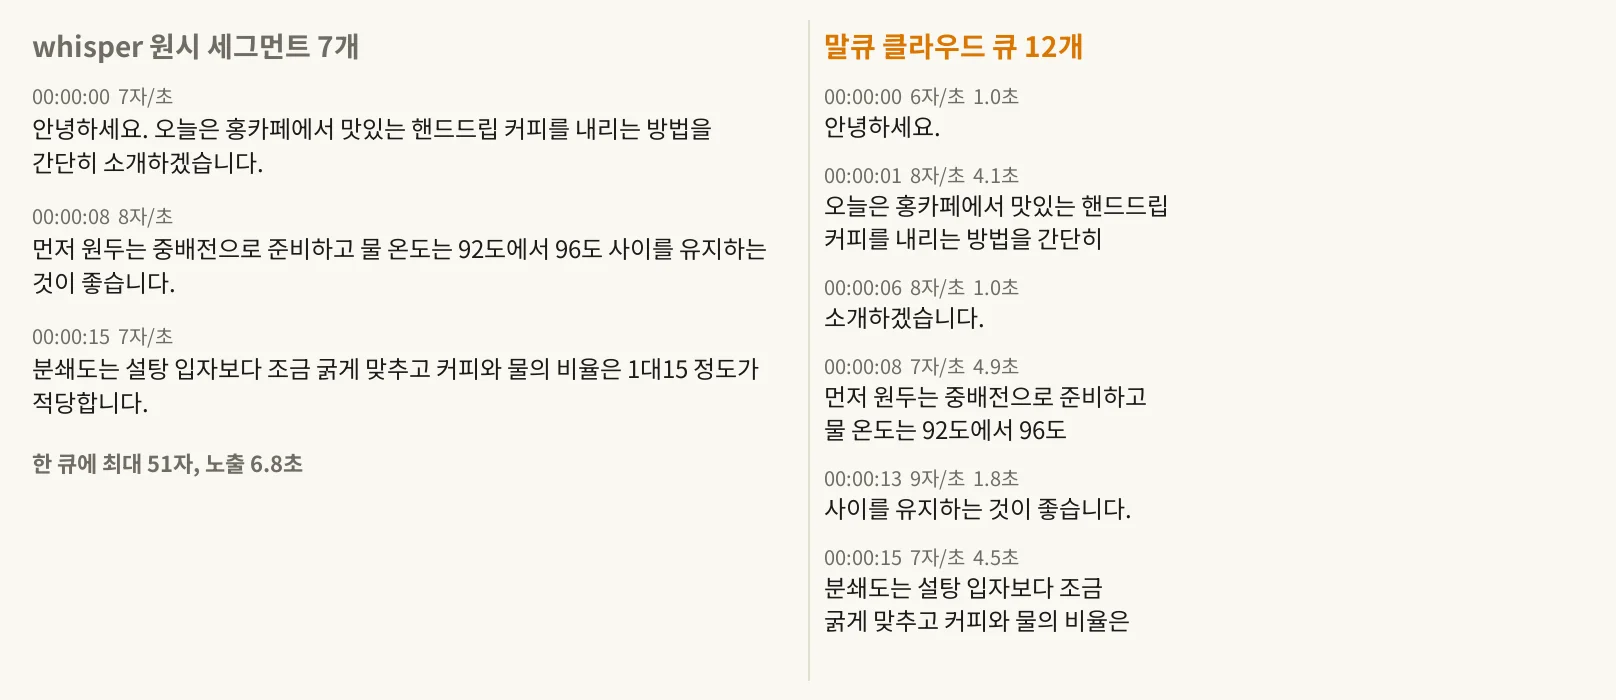
왼쪽은 whisper 가 처음 나눈 그대로입니다. 한 큐에 최대 51자가 6.8초 동안 뜹니다. 오른쪽은 말큐 클라우드가 다시 나눈 큐이고, 줄과 초당 글자 수가 기준 안에 들어옵니다. 왼쪽 "홍카페"는 "홈카페"를 잘못 들은 인식 오류로, 인식기를 거치면 이런 오류가 남습니다.
실측
Ubuntu 컨테이너, 2 CPU, 4GB 메모리, 음성 인식 small 모델 기준입니다.
| 입력 | 큐 | 음성 인식 | 번인 | 비고 |
|---|---|---|---|---|
| 한국어 42초, 1280x720 | whisper 7개 -> 12개 | 10초 | 3~7초 | 품질 검사 문제 없음 |
| 영어 2분 25초, 1280x534 | 18개 | 9초 | 29초 | 결과 24.4MB |
| 영어 9분 40초, 1280x534 | 60개 | 36초 | 109초 | 최대 메모리 0.9GB |
첫 실행에서 작업 공간이 글꼴(약 10MB)과 음성 인식 모델(약 460MB)을 내려받는 데 20~70초가 더 듭니다. 번역은 에이전트가 쓰는 시간이라 큐 수와 언어 수에 따라 따로 걸립니다. 1920x1080 번인은 위 표보다 3배쯤 오래 걸리리라 예상합니다(측정하지 않은 추정).
하지 않는 것
- 번역은 초안입니다. 법률, 의료, 계약 문서처럼 틀리면 안 되는 내용은 사람이 검수해야 합니다.
- 화자 구분, 노래 가사 타이밍, 글자 애니메이션 효과는 없습니다. 자막 스타일은 영상 하나에 하나입니다.
- 겹쳐 말하는 소리, 심한 사투리, 음악이 깔린 말, 전문 용어와 고유명사는 틀릴 수 있습니다. 올리기 전에 한 번 읽어 보세요.
- 20분이 넘는 영상은 처리하지 않습니다. 잘라서 올려 주세요.
- 일본어·중국어 줄바꿈은 형태소 분석이 아니라 글자 종류 경계로 합니다. 복합어가 중간에서 끊어질 때가 드물게 있습니다.
- 정확도 수치는 약속하지 않습니다. 샘플 결과는 샘플일 뿐입니다.
자주 묻는 질문
설치할 게 있나요? 없습니다. 영상을 올리고 대화만 하면 됩니다.
지원하는 파일은요? MP4, MOV, MKV, WEBM 영상과 MP3, WAV, M4A 음성, 20분 이하, 2GB 이하입니다. 음성 파일은 자막 파일만 나오고 번인 영상은 없습니다.
몇 개 언어로 번역되나요? 에이전트가 번역할 수 있는 언어면 됩니다. 줄 길이 기준은 한국어, 영어, 일본어, 중국어에 맞춰 두었고 다른 언어는 줄당 20자, 초당 18자 기준을 씁니다. 영상에 입히는 글꼴은 한국어, 일본어, 영어 등 라틴 문자, 러시아어를 지원합니다. 간체 중국어, 태국어, 아랍어는 SRT·VTT 파일만 받을 수 있습니다.
번역이 이상하면요? 같은 대화에서 "3번 큐를 더 짧게", "존댓말로"처럼 말하면 해당 부분을 고쳐 다시 만듭니다.
자막을 영상 위에 입히지 않고 파일만 받을 수 있나요? "파일만 줘"라고 하면 번인을 건너뜁니다.
영상이 외부로 나가나요? 에이전트의 클라우드 작업 공간 안에서만 처리합니다. 밖에서 받는 것은 처음 한 번 내려받는 음성 인식 모델과 글꼴뿐이고, 올린 영상과 자막은 어디에도 보내지 않습니다.
문의는요? [email protected]
구매 안내
| 플랜 | 가격 | 요청 횟수 |
|---|---|---|
| 주간 | US$3.99 | 5회 |
| 월간 | US$9.99 | 15회 |
| 연간 | US$79.99 | 월 12회 |
요청 횟수는 플랜마다 정해진 한도입니다. 무료 체험은 없습니다. 언제든 해지할 수 있습니다.
예시 영상: Tears of Steel (c) Blender Foundation | mango.blender.org, CC BY 3.0.
