social-video-transcript-extractor
name: social-video-transcript-extractor
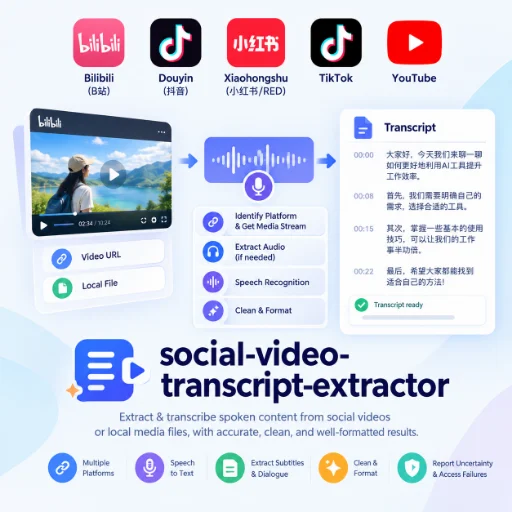
description: This skill should be used when a user wants to extract or transcribe the spoken script from a video on Bilibili (B站/哔哩哔哩), Douyin (抖音), Xiaohongshu (小红书/RED), TikTok, or YouTube, including requests such as video-to-text, speech-to-text, extracting dialogue, extracting subtitles, making a口播稿, or converting a local video/audio file into a readable transcript. It identifies the platform or source, obtains an accessible media stream or local file, extracts audio when needed, runs speech recognition, cleans and formats the result, and reports uncertainty or access failures without inventing content.
多平台视频口播文稿提取器
名称与用途
- Skill 名称:
social-video-transcript-extractor - 中文名称: 多平台视频口播文稿提取器
- 用途: 从 B站、抖音、小红书、TikTok、YouTube 视频,或用户提供的本地视频/音频中,提取可阅读、可编辑的中文或多语言口播文稿。
- 交付重点: 还原实际说话内容;保留原意、顺序和说话人区分;对听不清、无法访问或无法确认的部分明确标注,不猜写、不补写。
触发条件
在出现下列任一平台名称、别名或任务表述时启用本 Skill:
平台触发词
- B站:
B站、哔哩哔哩、bilibili、b23.tv - 抖音:
抖音、Douyin、douyin.com - 小红书:
小红书、RED、XHS、xiaohongshu、xhslink.com - TikTok:
TikTok、Tik Tok、抖音国际版、tiktok.com - YouTube:
YouTube、YouTube Shorts、YT、youtu.be、youtube.com
任务触发词
口播文稿、口播稿、文案转写、语音转文字视频转文字、视频听写、音频转写、ASR提取台词、提取对白、提取字幕把视频内容整理成文字、把视频说的话写出来生成逐字稿、生成文字稿、transcript、transcribe
仅要求总结视频主题、分析内容、改写文案或翻译已有字幕时,不默认启用本 Skill;只有任务包含“还原视频中的说话内容”或同义要求时才启用。
工作流总览
按以下顺序执行,并在最终结果中说明实际完成到哪一步:
- 接收并规范化输入
- 识别平台与访问方式
- 获取可处理的媒体源
- 提取并标准化音频
- 语音识别与时间对齐
- 口播文稿清洗与结构化
- 质量检查、异常标注与交付
1. 接收并规范化输入
支持以下输入:
- 平台视频链接:B站、抖音、小红书、TikTok、YouTube 的公开链接、分享链接或短链接。
- 本地视频文件:
.mp4、.mov、.mkv、.webm、.avi等常见格式。 - 本地音频文件:
.mp3、.wav、.m4a、.aac、.flac等常见格式。 - 已下载的字幕或语音转写文件:
.srt、.vtt、.ass、.txt、.json。 - 多个链接或文件:逐项处理,分别输出,避免把不同视频的口播内容混在一起。
先做以下检查:
- 去除链接首尾空格,保留完整 URL、短链接和必要的查询参数。
- 检查文件是否存在、格式是否可读、文件大小是否为零。
- 从 URL 主机名和路径识别平台;无法判断时标记为
unknown,继续尝试通用媒体流程。 - 记录用户指定的语言、是否需要时间戳、是否需要逐字保留语气词、是否需要区分说话人。
- 未指定语言时,先根据音频试听/自动检测判断;无法确定时使用多语言识别,并在结果中报告判断。
2. 平台识别与访问决策
使用以下平台映射:
| 平台 | 常见 URL 特征 | 识别结果 |
|---|---|---|
| B站 | bilibili.com、b23.tv |
bilibili |
| 抖音 | douyin.com、抖音分享短链 |
douyin |
| 小红书 | xiaohongshu.com、xhslink.com |
xiaohongshu |
| TikTok | tiktok.com |
tiktok |
| YouTube | youtube.com、youtu.be |
youtube |
访问策略按优先级执行:
- 优先使用用户直接上传的本地视频/音频。
- 对公开且可访问的平台链接,尝试获取公开媒体流、平台提供的字幕或音频。
- 若平台页面能访问但媒体流不可直接获取,尝试读取公开字幕;字幕可用时标记来源为
platform captions,不要假称为重新识别。 - 若链接需要登录、验证码、地区限制、付费权限、私密权限、DRM 或反自动化验证,立即停止绕过尝试,改为请求用户上传视频/音频文件,或提供可访问的媒体文件。
- 不破解 DRM,不绕过登录或验证码,不抓取用户未授权的私密内容,不通过不明第三方服务上传敏感视频。
平台链接本身不等于一定可以下载。结果中应区分:已获取媒体、已获取平台字幕、仅能访问页面、无法访问。
3. 获取媒体与提取音频
在已有字幕足以满足用户要求时,可直接进入文稿清洗,但仍需说明“基于平台字幕”,并保留字幕中的不确定性。
需要从视频识别时:
- 获取可读的视频或音频文件,并记录来源平台、原始 URL、文件格式和处理时间。
- 检查媒体是否含音轨;无音轨时转为异常处理。
- 使用可用的媒体工具提取音频,推荐标准化为:单声道、16 kHz、PCM WAV;保留原始文件,不覆盖用户文件。
- 长视频按连续时间段切分,切分位置尽量避开句中,合并转写时保持原始顺序。
- 对背景音乐、多人同时说话、爆音、严重混响、环境噪声等情况做质量标记。
如果当前环境没有可用的下载器、媒体解码器或语音识别能力,不要伪造“已转写”;返回明确的缺失能力,并优先请求用户上传音频/视频或提供现成字幕。
4. 语音识别与时间对齐
按以下原则调用可用的本地或已连接语音识别能力:
- 自动检测语言;用户指定语言时以用户指定为准。
- 尽可能启用时间戳;至少保留片段起止时间,便于回听核对。
- 中文识别使用自然分句和中文标点;英文、日文、西班牙文等按原语言标点输出,不要未经要求翻译。
- 保留关键口语特征,例如“嗯”“那个”“对吧”、重复、停顿和语气词;如果用户要求“整理版”,再做轻度去重和分段。
- 多人说话时启用说话人分离;无法可靠区分时使用“说话人 A/B”或“[多人重叠]”,不猜测姓名。
- 专有名词、品牌、账号名、数字和外语词汇进行二次核对;无法确认时使用候选词并标注
[待核对]。 - 听不清内容使用
[听不清 00:12]、[疑似:xxx 00:12]等标记,禁止用上下文臆测补全。
5. 文稿清洗与输出结构
默认输出“可编辑口播稿”,不是内容总结。建议包含:
# 视频口播文稿

- 来源平台:YouTube
- 原始链接:https://example.com/...
- 识别语言:中文
- 转写来源:语音识别 / 平台字幕 / 用户提供字幕
- 音频时长:03:21
- 置信度备注:专有名词与背景音乐覆盖处已标注

## 口播正文

[00:00] 大家好,今天我们来...
[00:08] 首先要看三个地方...

## 不确定片段

- [00:42] 疑似“低代码平台”,请结合原音核对。
根据用户要求选择输出形式:
- 纯文字版: 仅输出连续口播正文,适合复制到文案编辑器。
- 时间戳版: 每个片段带
[MM:SS]或[HH:MM:SS],适合回听核对。 - 逐字版: 尽量保留语气词、重复、停顿和口头表达。
- 整理版: 只删除明显的无意义重复、口头填充词和断句噪声,不改变事实和语气意图。
- 字幕格式: 用户明确需要时输出
.srt或.vtt;时间轴必须来自实际对齐结果,不要凭空生成。 - 机器可读版: 用户明确需要时输出 JSON,至少包含
source、platform、language、segments、warnings;segments中包含start、end、text。
多个视频必须分别用独立标题或独立文件输出,并在每项前写明来源平台和链接尾部标识。
6. 质量检查
交付前检查:
- 文稿是否来自目标视频,而不是摘要或猜测。
- 时间顺序是否正确,是否发生片段重复或遗漏。
- 口播正文与字幕/ASR 来源是否区分清楚。
- 不确定内容、无声片段、重叠说话、语言切换和专有名词是否有标记。
- 是否保留用户要求的语气词、重复、说话人和时间戳。
- 是否泄露了不必要的登录信息、访问令牌、私人链接或本地隐私路径。
- 若输出字幕文件,时间轴是否单调递增且无明显重叠。
支持场景
- 公开平台视频链接的口播内容提取。
- 用户上传的视频或音频转写。
- 已有平台字幕、SRT、VTT 或转写 JSON 的整理与标准化。
- 中文、英文及可用识别引擎支持的多语言口播。
- 单人讲解、访谈、多人对话、带背景音乐的视频;复杂音频需附质量说明。
- 短视频、长视频和 Shorts/Reels 类短片;长视频按片段处理后合并。
不支持或不应执行的场景
- 需要破解 DRM、绕过登录/验证码/付费墙或访问私密内容。
- 无用户授权的受限视频、他人私密文件或明显侵犯隐私的内容。
- 只有视频标题、简介或缩略图,却要求还原完整口播正文。
- 音频不存在、文件损坏、严重静音,且没有任何可用字幕或替代音源。
- 用户只给出无法解析的分享口令、截图或文字描述,要求生成原视频逐字稿。
- 要求把听不清部分“按上下文补全”或伪造原话。
- 需要法律、医疗、金融等高风险领域的事实核验时,口播转写只能作为原始材料,不能替代专业核验。
异常与失败处理
使用“问题类型 → 处理动作 → 用户下一步”的格式报告,不只返回笼统的“失败”。
| 问题 | 处理动作 | 给用户的下一步 |
|---|---|---|
| URL 无法识别 | 展示识别到的域名,尝试通用流程 | 请提供完整链接或上传文件 |
| 短链接失效/重定向失败 | 不猜目标地址,不伪造平台 | 请复制浏览器最终 URL |
| 页面可访问但媒体不可取 | 尝试公开字幕;失败则停止 | 上传视频/音频或提供字幕文件 |
| 需要登录、验证码、地区或权限 | 不绕过限制 | 请上传本人有权处理的文件 |
| 文件格式不支持/损坏 | 说明文件检查结果 | 转为 MP4、MP3、WAV 或重新上传 |
| 无音轨/音频静音 | 报告无音轨或有效音频 | 提供含声音的版本或现成字幕 |
| ASR 引擎不可用 | 不输出虚构文稿 | 提供字幕,或在具备 ASR 的环境重试 |
| 背景噪声/多人重叠 | 输出可识别部分并标注时间 | 提供更清晰音频,或允许人工核对 |
| 语言混杂/专有名词多 | 保留原文和不确定标记 | 指定语言或提供术语表 |
| 处理超时/文件过长 | 分段处理,保留已完成进度 | 允许继续分段或提供目标时间区间 |
部分成功时交付已确认的片段,并明确列出未完成区间;不要把部分结果包装成完整逐字稿。
各平台使用示例
B站 / 哔哩哔哩
“提取这个 B站视频的口播文稿,保留时间戳和语气词:
https://www.bilibili.com/video/BV...”
执行要点:识别为 bilibili,先尝试公开媒体或字幕;若只能读取页面而不能获取媒体,要求上传视频或音频。
抖音
“把这个抖音链接里的说话内容转成纯文字口播稿,不需要总结:
https://v.douyin.com/...”
执行要点:先解析分享短链接;重定向失败时要求用户提供最终 URL 或直接上传视频。平台限制、登录和验证码不得绕过。
小红书
“读取这个小红书视频的口播,输出逐字版并标记听不清的地方:
https://www.xiaohongshu.com/...”
执行要点:识别为 xiaohongshu,优先使用公开字幕或可访问媒体;无法获取时交付明确失败原因,不将标题和笔记正文当成口播。
TikTok
“请转写这个 TikTok 视频,原文保留英文,另外单独给一份中文翻译:
https://www.tiktok.com/@user/video/...”
执行要点:先输出英文原文口播稿;翻译属于后处理,必须与原文分栏,不能用翻译替代转写。地区限制或登录限制按统一异常流程处理。
YouTube
“把这个 YouTube 视频 00:35 到 02:10 的口播转成带时间戳的中文文稿:
https://youtu.be/...”
执行要点:按用户指定时间区间截取;优先区分“平台字幕”和“重新语音识别”的来源;若视频有多个音轨或语言,说明实际使用的音轨。
本地文件
“把
D:/素材/产品介绍.mp4转成可直接修改的口播稿,删除明显的嗯和重复,但保留原意。”
执行要点:读取本地文件,提取音频,执行 ASR,按“整理版”规则输出,并列出听不清片段。
安全与真实性底线
- 只处理用户有权访问或提供的内容。
- 不绕过平台权限、验证码、DRM、付费墙或反自动化措施。
- 不把摘要、标题、评论或模型推断冒充视频原话。
- 不补写听不清的内容;所有不确定内容都要可定位、可复核。
- 不在结果中暴露令牌、Cookie、账号密码或不必要的本地隐私路径。
- 对外发布、代发或将文稿上传到第三方服务前,先取得用户明确确认。