컷싹 | 촬영 원본의 무음과 "음·어"를 잘라 드립니다
컷싹 | 촬영 원본의 무음과 "음·어"를 잘라 드립니다
촬영 원본 30분, 컷 편집 노가다 대신 채팅에 올리기만 하세요.
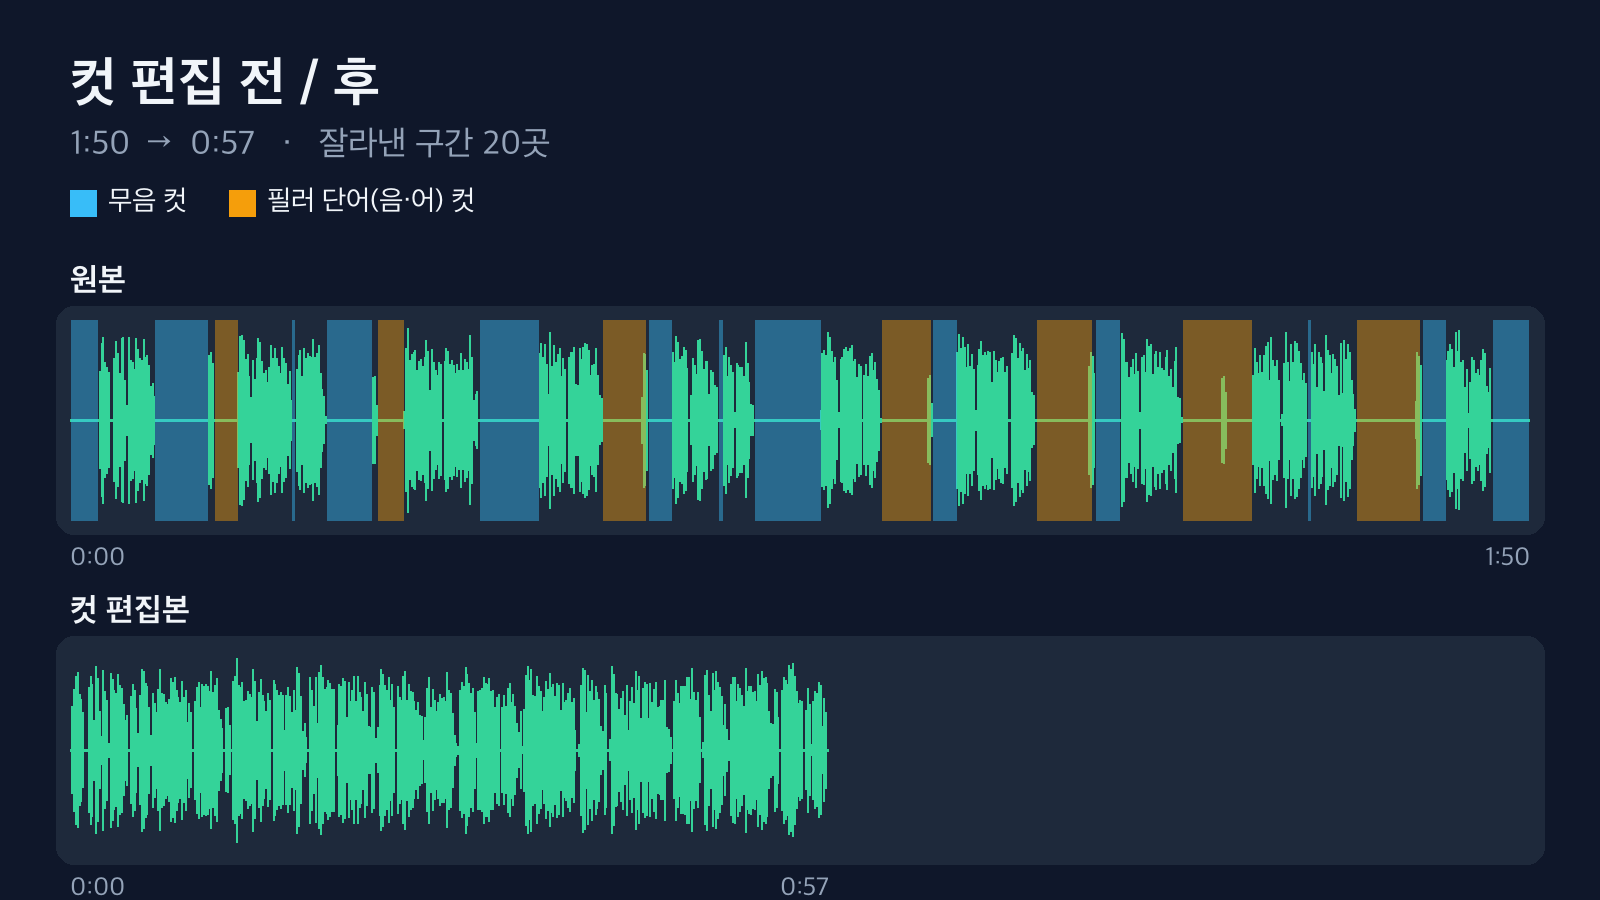
합성 음성 110초 샘플의 실제 결과. 파란 칸은 무음 컷, 주황 칸은 "음·어" 컷입니다.
강의나 브이로그를 찍고 나면 재생 막대를 끌며 쉬는 구간과 "음...", "어..."를 하나씩 찾아 자르는 일이 남습니다. 컷 하나는 쉬운데 개수가 많습니다. 컷싹은 그 구간을 찾아 잘라낸 영상과, 편집 프로그램에서 이어 작업할 편집 목록을 만들어 줍니다.
내 컴퓨터에 아무것도 설치하지 않습니다. Capafy 클라우드에서 돌아갑니다.
테스트 영상으로 만든 데모입니다.
이렇게 씁니다
대화창에 영상을 올리고 한 줄만 쓰면 됩니다.
이 영상에서 무음이랑 "음", "어" 잘라 줘.
끝나면 같은 대화로 파일이 돌아옵니다. 대기 시간은 1분 50초 영상이 약 30초, 11분 영상이 약 3분 20초였습니다.
받는 것
| 파일 | 내용 |
|---|---|
이름_cut.mp4 |
무음·필러를 잘라 이어붙인 영상. 컷마다 25ms 오디오 페이드를 넣어 딸깍 소리를 막습니다 |
이름.fcpxml |
프리미어·다빈치·파이널컷에서 원본 영상 기준으로 이어 편집하는 시퀀스 |
이름.edl |
CMX3600 편집 목록. 다빈치에서 불러옵니다 |
이름.csv |
컷 위치 표. 어디를 잘랐는지 눈으로 확인합니다 |
summary.md |
길이 변화, 컷 개수, 음성·영상 길이 차이 |
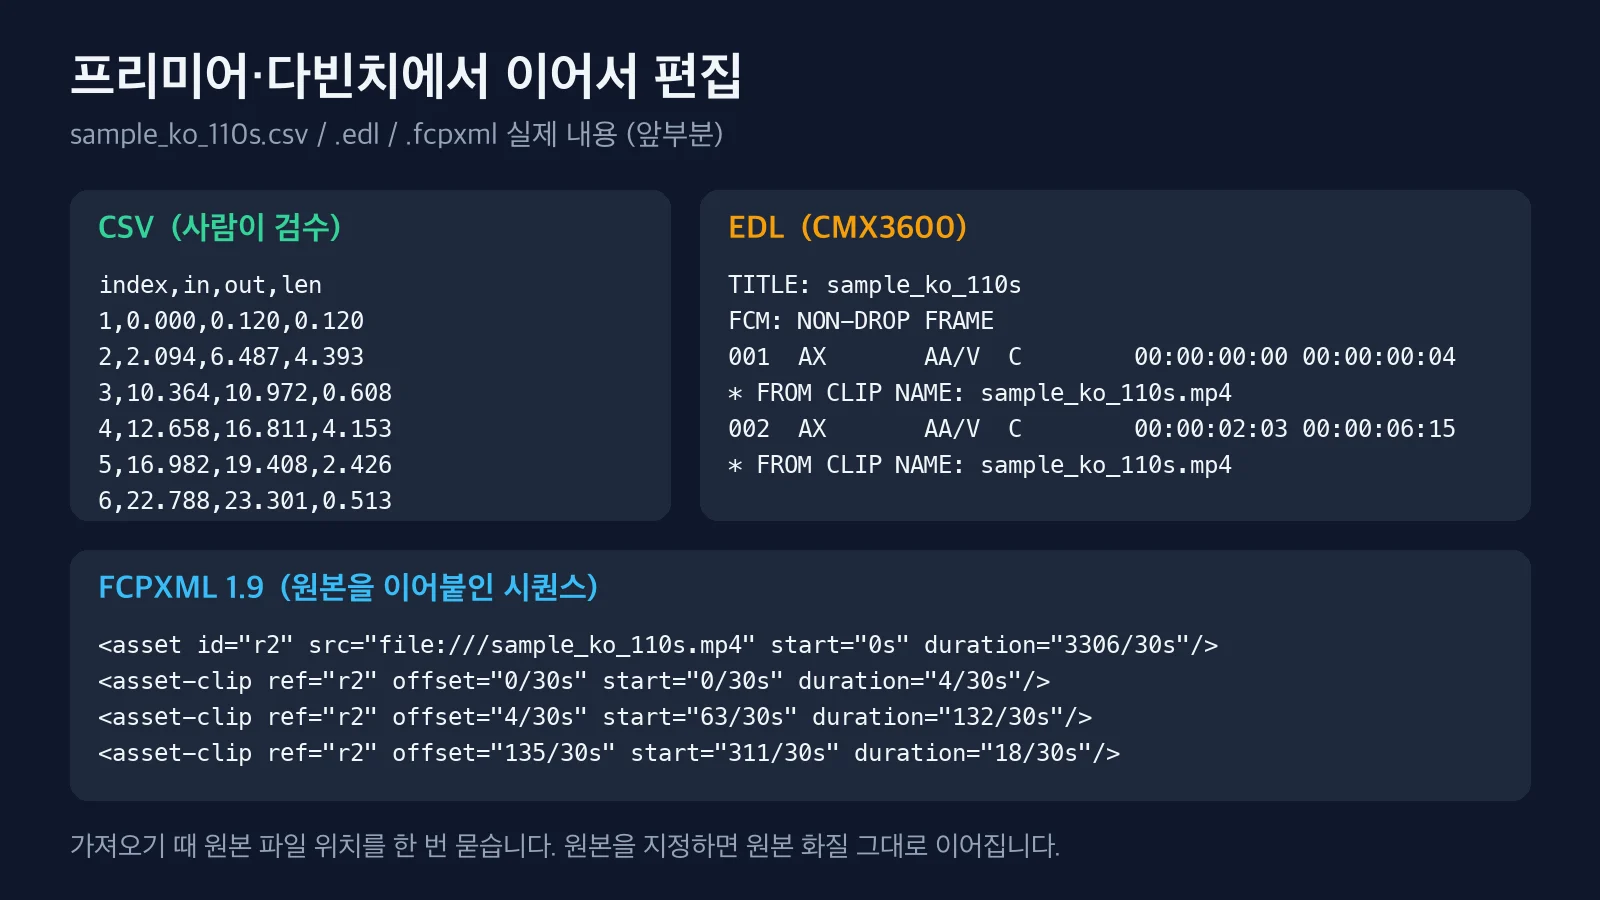
편집 목록은 원본 파일 이름만 기록합니다. 처음 가져올 때 원본 영상 위치를 한 번 지정하면 원본 화질 그대로 이어집니다.
실제 결과
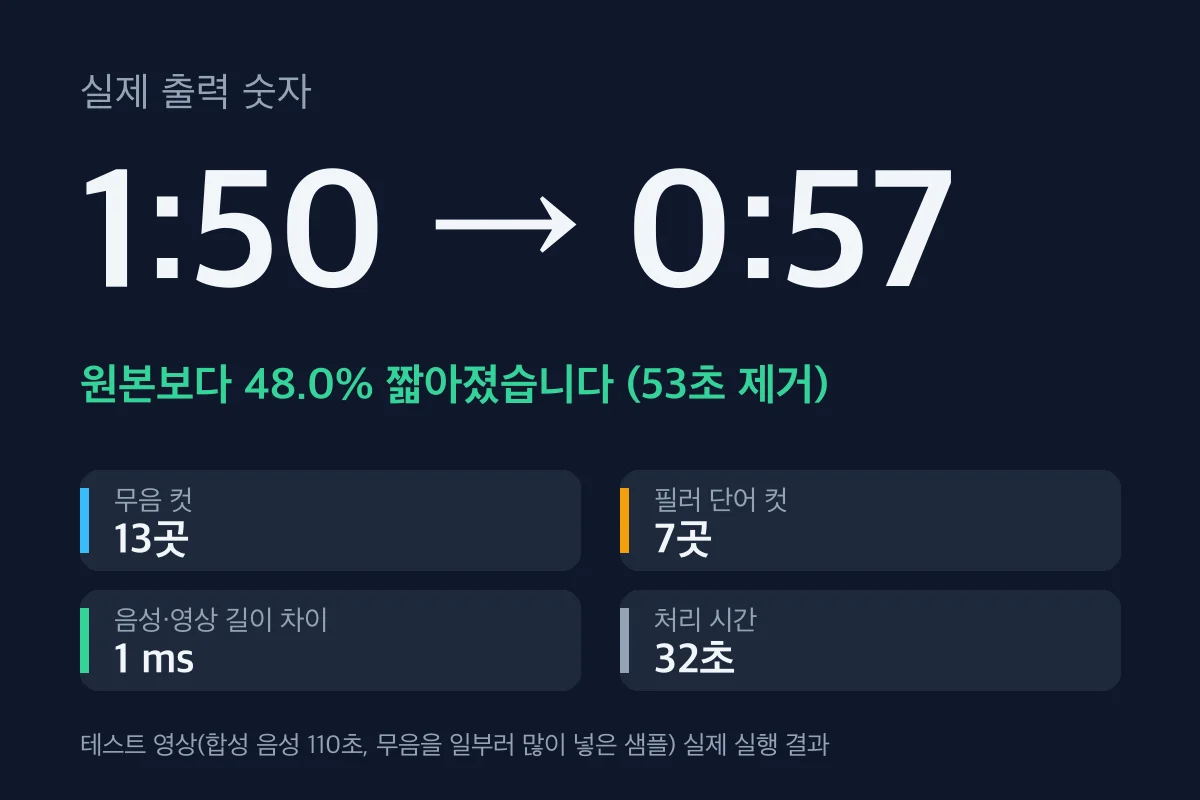
합성 음성 샘플(무음을 일부러 많이 넣음)이라 줄어든 비율이 큽니다. 실제 촬영본은 보통 이보다 덜 줄어듭니다.
| 입력 | 환경 | 결과 | 시간 |
|---|---|---|---|
| 1분 50초 샘플 | 2 CPU, 4GB | 0:57로 단축, 컷 20곳(무음 13, 필러 7), 음성·영상 차이 1ms | 32초 |
| 같은 샘플, 필러 탐지 끔 | 같음 | 0:59, 컷 21곳 | 12초 |
| 11분 1초 샘플 | 같음 | 5:37로 단축, 컷 109곳(무음 69, 필러 40), 음성·영상 차이 31ms | 193초 |
샘플에 일부러 넣은 "음·어" 42개 가운데 40개 위치를 찾았고, 찾은 42개는 모두 실제 위치와 겹쳤습니다. 합성 음성 기준이며 사람 목소리의 웅얼거림은 더 틀릴 수 있습니다.
이 에이전트가 하지 않는 것
- 하이라이트나 쇼츠 구간 고르기. 영상 전체에서 죽은 시간만 걷어냅니다.
- 다시 말한 문장, 실수한 테이크 삭제. 소리가 있으면 남깁니다.
- 자막, 배경음악, 색 보정.
- 필러를 전부 찾기. 음성 인식 모델이 놓치거나 잘못 알아듣는 경우가 있고, 잡은 개수를 결과에 적습니다.
- 말이 쉬지 않고 이어지는 영상(연설 등)은 자를 곳이 거의 없어 결과가 원본과 비슷합니다.
자주 묻는 질문
컷이 너무 촘촘해요. "쉬는 구간 0.6초 이상만 잘라 줘"라고 쓰면 민감도를 바꿔 다시 돌립니다. 말끝이 잘리면 "여유를 더 줘"라고 하세요.
필러는 어떤 말을 잡나요? 한국어는 음, 으음, 어, 그니까, 인제. 영어는 um, uh, erm, hmm. "그게", "저기"처럼 실제 낱말로 쓰이는 말은 뺐습니다.
영어 영상도 되나요? 됩니다. "영어야"라고 알려 주세요.
영상이 밖으로 나가나요? 에이전트 작업 공간 안에서만 처리합니다. 외부에서 받는 것은 음성 인식 모델 한 번뿐입니다.
한 번 요청은 뭔가요? 영상 하나를 잘라 결과를 받는 것이 1회입니다. 같은 영상의 설정 변경 재실행은 별도 요청으로 셉니다.
길이 제한은? 5초에서 30분, MP4·MOV·MKV·WEBM. 30분 영상은 약 9분 걸릴 것으로 추정합니다(11분 영상 실측에서 환산).
테스트 영상은 합성 음성으로 직접 만든 샘플입니다.